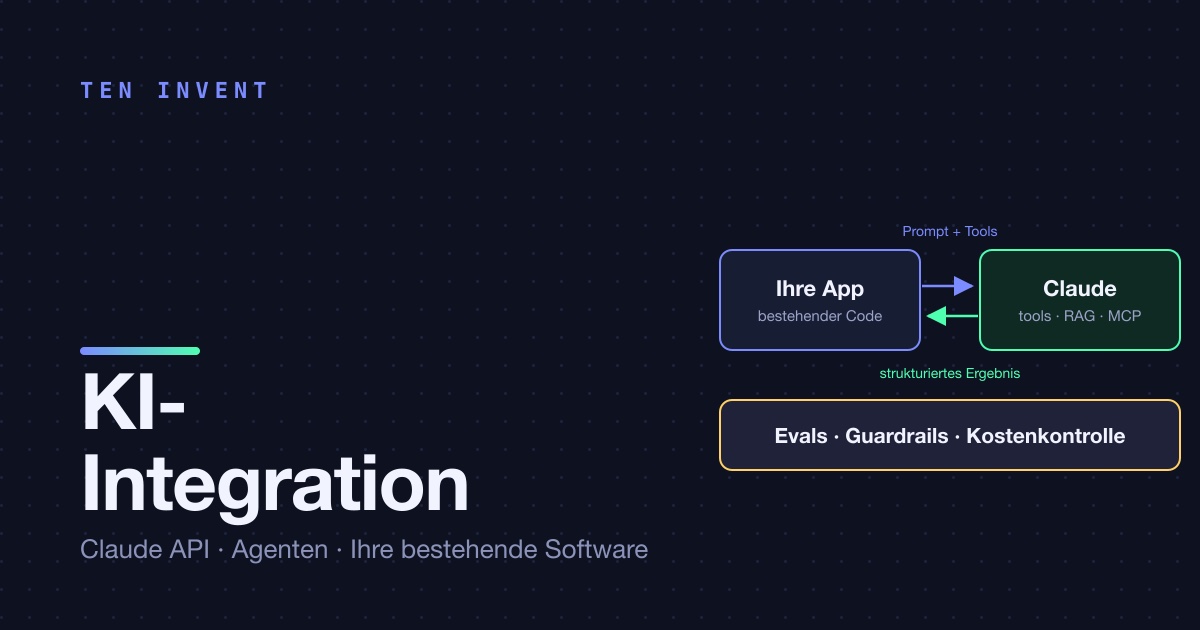
Drei von uns gebaute KI-Systeme sind heute in Produktion. Ein Recherche-Assistent für einen US-Kunden, der auf AWS Bedrock läuft, mit einem Orchestrator und zehn spezialisierten Sub-Agenten, fünfundzwanzig Tools und Retrieval über einen indexierten Korpus aus Fördermitteln und Publikationen. Bob, unser eigener Multi-Tenant-Assistent, mit Konversationsgedächtnis, Dokumenten-Retrieval, Sprache und einer E-Mail-Integration. Und der Fragengenerator innerhalb von tenSurvey, der Umfragefragen in mehr als dreißig Sprachen schreibt.
Keines davon begann mit einem Modell. Sie begannen mit einer Tabelle echter Fälle und einer Frage: Funktioniert das auf unseren Daten gut genug, um es zu bauen? Dieser Artikel ist die Methode, mit der wir diese Frage beantworten und ein Ja in ein Feature verwandeln, das den Kontakt mit echten Nutzern übersteht.
Schritt 1: der Spike, zwei Wochen auf echten Daten
Jedes Projekt beginnt mit einem Spike, und der Spike beginnt mit Daten. Wir bitten um fünfzig bis zweihundert echte Beispiele der Aufgabe: die Dokumente, die zusammengefasst werden müssen, die Tickets, die klassifiziert werden müssen, die Fragen, die Menschen tatsächlich stellen. Nicht die sauberen Fälle. Die mit Tippfehlern, fehlenden Feldern und dem Grenzfall, den nur die Person kennt, die den Job seit fünf Jahren macht.
Dann bauen wir die dünnstmögliche Pipeline und messen. Bei einer Dokumentenextraktion bedeutet das: Modell, Prompt, strukturierte Ausgabe, ein Skript, das alle zweihundert Fälle durchläuft und sie mit dem vergleicht, was ein Mensch gesagt hat. Beim Recherche-Assistenten bedeutete es: Findet Retrieval die richtige Passage im Korpus, und zitiert die Antwort sie? Das Ergebnis des Spikes ist eine Tabelle mit Genauigkeit, Latenz und Kosten pro Fall, sowie eine Empfehlung, die manchmal lautet: „Das noch nicht bauen."
Diese Empfehlung ist schon vorgekommen. Eine Klassifizierungsaufgabe, bei der das Modell in 82 % der Fälle mit den menschlichen Prüfern übereinstimmte, klingt beeindruckend, bis man erfährt, dass die Prüfer nur in 84 % der Fälle untereinander übereinstimmten. Die Aufgabe war mehrdeutig, nicht das Modell. Wir verbrachten die zweite Woche damit, dem Kunden zu helfen, die Kategorien zu schärfen, statt an Prompts zu feilen, und das spätere Feature war dadurch besser.
Schritt 2: das Golden Dataset, vor der Architektur
Die zweihundert Fälle aus dem Spike werden zum Golden Dataset: Eingaben gepaart mit dem, was „korrekt" bedeutet, abgestimmt mit dem Kunden. Es liegt im Repository neben dem Code und läuft in CI bei jeder Änderung an einem Prompt, einer Modellversion, einer Retrieval-Einstellung oder einer Tool-Definition.
Das ist das mit Abstand wichtigste Artefakt in einem KI-Projekt, und dasjenige, das die meisten Teams auslassen. Ohne es ist jede Prompt-Änderung ein Bauchgefühl. Mit ihm besteht eine Änderung entweder das Gate oder nicht, und die Zahl ist für alle im Pull Request sichtbar. Wenn Anthropic ein neues Modell veröffentlicht, lassen wir das Golden Set noch am selben Nachmittag dagegen laufen und wissen innerhalb einer Stunde, ob wir wechseln sollten. Genau das haben wir getan, als Fable 5.1 Fable 5 ersetzte.
Schritt 3: Architektur, die davon ausgeht, dass das Modell falsch liegen wird
Sobald der Spike ein Ja ergibt, entwerfen wir das System um eine Annahme herum: Das Modell wird gelegentlich falsch liegen, und die Architektur muss dies sicher und sichtbar machen.
Modellzugriff. Auf AWS nutzen wir Claude über Bedrock: Die Daten bleiben im Konto und in der Region des Kunden, nichts wird zum Training verwendet, und IAM steuert, wer was aufrufen darf. Außerhalb von AWS nutzen wir direkt die Anthropic-API. Wenn Daten ein privates Netzwerk überhaupt nicht verlassen dürfen, haben wir offene Modelle auf der eigenen Hardware des Kunden betrieben; unsere Notizen zu Mistrals offenem Mixture-of-Experts-Release und zum Betrieb von Claude Code gegen ein lokales Modell stammen aus dieser Arbeit.
Strukturierte Ausgaben, per Code validiert. Jede Modellantwort, die ein System speist, ist ein typisiertes Objekt, validiert bevor sie verwendet wird. Eine Zusammenfassung ist ein String; eine extrahierte Rechnung ist ein Schema mit Beträgen, die aufgehen müssen. Schlägt die Validierung fehl, versucht der Code es mit dem Fehler erneut und fällt dann auf eine menschliche Warteschlange zurück. Das Modell schreibt nie direkt in eine Datenbank.
Retrieval mit Zitaten. Bei allem, was aus Dokumenten beantwortet wird, trägt die Antwort die Passagen, aus denen sie entstanden ist, und die Benutzeroberfläche zeigt sie an. Hybride Suche (Keyword plus Embeddings) auf PostgreSQL mit pgvector deckt die meisten Korpora ab; OpenSearch, wenn der Korpus groß oder die Abfragemuster komplex sind. Wir stimmen Chunking und Re-Ranking am Golden Set ab, nicht an einem Benchmark.
Agenten, die vor dem Handeln fragen. Der Recherche-Assistent nutzt einen Orchestrator, der plant und an spezialisierte Sub-Agenten delegiert, jeder mit einer engen Menge an Tools, die über MCP-Server mit expliziten Scopes verfügbar gemacht werden. Lesen ist frei; alles, was den Zustand außerhalb des Systems ändert, wartet auf einen menschlichen Klick. Das Audit-Log erfasst jeden Tool-Aufruf mit seinen Eingaben, sodass „warum hat es das gemacht" immer eine Antwort hat. Wir haben über die dahinterliegende Plattform geschrieben in die Agent-Factory-Plattform und über das allgemeine Muster in Enterprise-KI-Agenten im großen Maßstab.
Prompt Injection ist ein Eingabeproblem. Dokumente, E-Mails und Webseiten, die einem Modell zugeführt werden, sind nicht vertrauenswürdig. Anweisungen darin sind Daten, niemals Befehle. Guardrails prüfen Eingaben auf Injection-Muster und Ausgaben auf durchgesickerte Geheimnisse oder unzulässige Inhalte, und die Sub-Agenten, die externe Inhalte lesen, besitzen keine Tools, die schreiben.
Schritt 4: Kosten, die man in ein Budget einplanen kann
Während des Spikes kennen wir bereits die Tokens pro Fall. Bevor der Bau beginnt, erhält der Kunde Kosten pro Dokument, pro Konversation oder pro Ticket, beim erwarteten Volumen, für zwei oder drei Modellauswahlen. Meist gewinnt an dieser Stelle das kleinste Modell, das die Evals besteht, und Prompt-Caching und Batching werden von vornherein eingeplant statt nachträglich angeflanscht.
In Produktion trägt jeder Aufruf die Token-Zahlen ins Tracing-System. Es gibt Budgets pro Feature und Alarme, wenn die Tagesausgaben die Prognose überschreiten. Wir haben gesehen, wie eine einzelne Retry-Schleife die Monatsrechnung eines von uns übernommenen Systems verdoppelt hat; ein Budget-Alarm hätte das innerhalb einer Stunde entdeckt. Für unsere eigenen Tooling-Kosten haben wir dieselbe Übung öffentlich gemacht in was 200 Dollar Claude wirklich kaufen.
Schritt 5: betreiben wie Software, weil es das ist
Das Feature wird stufenweise ausgeliefert: ein Prozent des Traffics, dann zehn, dann alle, während Evals und Tracing jede Stufe beobachten. Prompts werden im Repository versioniert, nicht in einem Dashboard. Modellversionen werden festgelegt und bewusst über das Golden Set hinweg aktualisiert. Fehler aus der Produktion werden wöchentlich gesichtet, und die interessanten werden zu neuen Golden Cases, was dafür sorgt, dass das Dataset von zweihundert auf zweitausend Fälle wächst, ohne dass jemand von Hand Testdaten schreibt.
Hier sind wir auch ehrlich darüber, was KI nicht repariert. Ein kaputter Prozess mit einem Modell davor ist ein schnellerer kaputter Prozess. Wir haben in diesem Jahr mehr als ein Projekt aus diesem Grund abgelehnt und gesagt, warum, in KI repariert Ihre kaputte App nicht.
Was wir nutzen, und was nicht
Wir bauen auf Claude, weil es das Modell ist, das bei den Evals unserer Kunden für agentenbasierte und dokumentenlastige Arbeit am besten abgeschnitten hat, und weil Bedrock die Unternehmensfragen (Datenresidenz, Training, IAM) leicht beantwortbar macht. Wir haben das Strands-Agentenframework auf Bedrock für Multi-Agenten-Systeme eingesetzt, MCP für Tools, pgvector und OpenSearch für Retrieval, und einfaches PostgreSQL für alles, was das Modell produziert. Wir haben mit niemandem eine Wiederverkäufer-Beziehung; wenn ein offenes Modell die Evals zu einem Bruchteil der Kosten besteht, sagen wir das auch.
Was wir nicht tun, sind Demos. Wenn ein Feature nicht an echten Daten gemessen werden kann, tun wir nicht so, als würde es funktionieren. Wenn Sie einen sprachlastigen Prozess haben, bei dem Sie vermuten, dass ein Modell ihn übernehmen könnte, schicken Sie uns fünfzig echte Beispiele, und wir sagen Ihnen in zwei Wochen, ob es funktioniert.