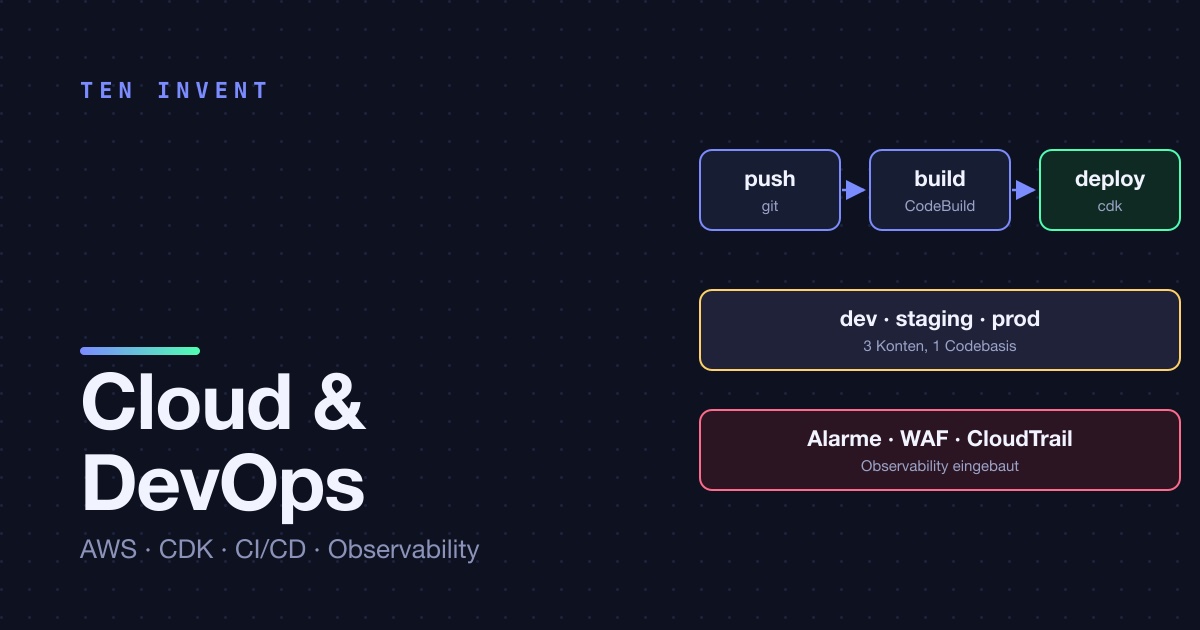
Wir betreiben AWS für unsere eigenen Produkte und für eine Kundenplattform mit echten Nutzern und echtem Geld, das hindurchfließt. Zwischen März und September dieses Jahres haben wir die meisten Fehler gemacht, die ein kleines Team auf AWS machen kann, und sie als 29-teilige Artikelserie aufgeschrieben. Dies ist die verdichtete Version: das Setup, mit dem wir jedes Projekt jetzt beginnen, wofür jedes Teil da ist, und wo die Leichen begraben liegen.
Kurz gefasst: drei Konten unter einer Organisation, jede Ressource in CDK, Container ohne Cluster, Deploys über GitHub ohne langlebige Schlüssel, Observability, die keinem Anbieter gehört, und eine monatliche Kostenprüfung. Nichts davon ist besonders clever. Alles davon ist aufgeschrieben.
Konten zuerst: Dev, Staging, Produktion, vom ersten Tag an
Das Erste, was wir erstellen, ist kein Server. Es ist eine AWS Organization mit drei Mitgliedskonten: Dev, Staging und Produktion. Derselbe CDK-Code, unterschiedliche Parameter, harte IAM-Grenzen dazwischen. Ein Fehler in Dev kann Produktionsdaten nicht berühren, weil er sie nicht einmal sehen kann.
Wir haben zu viele Plattformen übernommen, bei denen „Staging" eine zweite Datenbank auf dem Produktionsserver war und Dev der Laptop von irgendjemandem. Das nach dem Launch zu korrigieren ist eine Migration; es vor dem Launch zu tun ist ein Nachmittag. Wir haben das Argument dargelegt in Dev, Staging, Prod vom ersten Tag an und das Code-Layout gezeigt in drei AWS-Konten, eine CDK-Codebasis.
Deploys erreichen diese Konten von GitHub Actions über OIDC-Föderation: eine Rolle pro Konto, vertrauenswürdig nur für das richtige Repository und den richtigen Branch, ohne dass irgendwo Zugriffsschlüssel gespeichert sind. Wenn ein Engineer das Team verlässt, muss nichts rotiert werden. Das Setup sind hundert Zeilen CDK, und wir haben es veröffentlicht in GitHub-OIDC-Deploy-Rollen pro AWS-Konto.
Alles in CDK, und was das kostet
Jede Ressource ist TypeScript in einer CDK-App: Konten, Netzwerk, Datenbanken, Services, DNS, Alarme, IAM. Dieselbe Sprache wie die Anwendung, geprüft in denselben Pull Requests, getestet mit demselben Runner. Niemand klickt in der Konsole; wurde doch geklickt, ist das Drift, und es wird importiert oder gelöscht. Wir sind entspannt beim Werkzeug und streng beim Prinzip, wie wir in Infrastructure as Code bedeutet nicht Terraform erklärt haben.
CDK hat scharfe Kanten, und wir haben uns an den meisten davon geschnitten. CloudFormation-Stacks haben ein Limit von fünfhundert Ressourcen, und eine Plattform mit drei Anwendungen, Queues, Funktionen und Alarmen erreicht es schneller, als man denkt; wir kamen auf 493 und mussten Stacks aufteilen, ohne irgendetwas neu zu erstellen, was ein eigenes Verfahren ist (CloudFormation-Limit von 500 Ressourcen: einen Stack aufteilen). Ein Refactoring, das einmal eine logische ID änderte, löschte und erstellte zwei App-Runner-Services in Produktion neu; das Post-Mortem steht in CloudFormation hat unsere App-Runner-Services gelöscht, und die Regel seitdem lautet, dass jeder Diff, der eine zustandsbehaftete oder öffentlich zugängliche Ressource berührt, von zwei Personen gelesen wird, bevor deployt wird.
Geheimnisse leben nie im Template. Datenbankpasswörter, API-Schlüssel und Webhook-Secrets liegen in Secrets Manager oder SSM und werden beim Containerstart injiziert; die Container-Rolle kann genau diese ARNs lesen und sonst nichts. Die Abwägungen stehen in Secrets in CDK: Secrets Manager, SSM oder nichts im Template.
Container ohne die Cluster-Steuer
Sie brauchen kein Kubernetes. Für Produkte unter ein paar hundert Anfragen pro Sekunde, was auf die meisten Produkte zutrifft, liefern ECS auf Fargate oder App Runner dieselbe Zuverlässigkeit mit einem Bruchteil der Angriffsfläche. Wir haben die Begründung erklärt in Sie brauchen kein Kubernetes und es kein einziges Mal bereut.
App Runner ist unsere Standardwahl für Webanwendungen: ein Image pushen, HTTPS und Auto-Scaling bekommen, es aus CDK verwalten wie jede andere Ressource. Es hat echte Grenzen, ein 120-Sekunden-Gateway-Timeout und eine einminütige Kaltstartinstanz darunter, und wir wissen genau, wo sie liegen, weil wir in jede einzelne davon gelaufen sind. Die ehrliche Bewertung steht in App Runner nach sechs Monaten in Produktion. ECS auf Fargate ist die nächste Stufe, wenn ein Service einen VPC-internen Pfad, Sidecars oder feingranulare Skalierung braucht.
Images sind distroless und mehrstufig gebaut, was die Image-Größe halbierte und eine ganze Kategorie von CVE-Rauschen aus dem Scanner entfernte (Docker-Images für Node im Jahr 2026). Health-Checks prüfen die Datenbankverbindung und die eine nachgelagerte Abhängigkeit, die wirklich zählt, nicht nur ob der Port offen ist, denn Health-Checks, die lügen, sind schlimmer als keine.
Daten: verwaltet, gesichert, und tatsächlich wiederhergestellt
PostgreSQL auf RDS oder Aurora, verschlüsselt, in privaten Subnetzen, mit automatisierten Backups und einer Wiederherstellung, die geprobt wurde. Dieser letzte Teil ist der, den die meisten Teams auslassen. Wir stellen jeden Monat einen Produktions-Snapshot im Staging-Konto wieder her, lassen die Smoke-Tests dagegen laufen und stoppen die Zeit für das Ganze, denn Backups, die nie wiederhergestellt wurden, sind keine Backups.
Für kleine Workloads mit stoßweisem Traffic mögen wir Aurora Serverless v2; wir wissen auch, dass die halbe ACU als Untergrenze bedeutet, dass es nie kostenlos ist, und wir haben es ehrlich durchgerechnet in Aurora Serverless v2 im Test. Schemaänderungen erfolgen nach dem Expand-and-Contract-Prinzip, nie eine gesperrte Tabelle während eines Deploys (Zero Downtime ist eine Frage der Schema-Migrationsdisziplin), und das Datenbankpasswort rotiert nach Zeitplan, ohne dass es jemand bemerkt (das Datenbankpasswort ohne Ausfallzeit rotieren).
Queues sind SQS und EventBridge, nicht Kafka, solange es keinen Grund dafür gibt (Queues ohne Kafka). Worker sind Container oder Lambda-Funktionen, je nach Dauer, und jeder asynchrone Job ist idempotent, weil er zweimal laufen wird.
Observability, die Ihnen gehört
Logs, Traces und Metriken laufen über OpenTelemetry zu welchem Backend auch immer der Kunde bereits bezahlt, oder zu einem selbst gehosteten Stack, wenn er keins bezahlen möchte. Die Anwendung weiß nicht, welches; sie sendet Standardsignale, und der Exporter entscheidet. Als der Kunde dieses Jahr den Observability-Anbieter wechselte, betrug die Änderung an der Anwendung null Zeilen. Das Argument steht in Ihre Logs sollten nicht wissen, welche Cloud und Ihre Traces sollten nicht wissen, welche Cloud, und die Preisrealität in die wahren Kosten von Managed Observability bei 100 GB pro Tag.
Alarme sind wenige, und jeder verweist auf eine Seite im Runbook. Das Runbook ist für ein Team geschrieben, das keinen Bereitschaftsdienst hat, weil die meisten unserer Kunden keinen haben: was zu prüfen ist, was zu klicken ist, wen man anruft, in dieser Reihenfolge (Incident-Runbook für ein Team ohne Bereitschaftsdienst). Alarme, auf die niemand reagiert, werden gelöscht; Alarme, die nicht wissen, welche Cloud erklärt das Routing.
Die Rechnung, monatlich geprüft
Kosten sind ein Design-Input, keine Überraschung am Monatsende. Die teuerste Zeile auf einer kleinen AWS-Rechnung ist meist die, an deren Erstellung sich niemand erinnert: ein NAT-Gateway, das ein privates Subnetz bedient, das einen VPC-Endpoint hätte nutzen können (NAT-Gateway: die teuerste Zeile, die Sie nicht sehen). Danach überdimensionierte Datenbanken, für immer aufbewahrte Logs, und Rechenleistung, für die sich niemand auf einen Savings Plan festgelegt hat.
Jeden Monat gehen wir die Rechnung Zeile für Zeile mit dem Kunden durch. Für unser eigenes Drei-Personen-Unternehmen ist diese Übung öffentlich, in die AWS-Rechnung eines Drei-Personen-Startups, und die Überlegung zu Commitments in Reserved, Savings Plans oder nichts im kleinen Maßstab. Datenschutzrichtlinien in CloudWatch halten personenbezogene Daten aus den Logs heraus, bevor sie zum Compliance-Problem werden (CloudWatch-Datenschutzrichtlinien für PII).
Wie ein Projekt aussieht
Zuerst eine Assessment-Woche: Lesezugriff auf die Konten, die Pipelines und die letzten drei Rechnungen, und ein schriftlicher Bericht mit Prioritäten. Dann das Fundament: Konten, Netzwerk, CDK-Grundgerüst, OIDC-Deploys, der erste Service, der auf die neue Art läuft. Dann Migration, Umgebung für Umgebung, wobei der alte Pfad live bleibt, bis der neue verifiziert ist, nie ein Big-Bang-Wochenende. Dann entweder eine saubere Übergabe mit Schulung, oder wir bleiben für die monatliche Prüfung und Support bei Bedarf.
Wenn Ihre Infrastruktur von Hand gebaut wurde, oder Ihre Deploys von der einen Person erledigt werden, die nicht in den Urlaub gehen kann, erzählen Sie uns davon. Die Assessment-Woche hat einen festen Umfang, und der Bericht gehört Ihnen, egal wohin Sie damit gehen.