Anthropic a lancé Claude Haiku 5.5 le 7 octobre 2026, et sa grille tarifaire est de celles qu'on relit deux fois : 0,10 $ par million de tokens en entrée et 0,50 $ par million de tokens en sortie. Haiku 4.5 coûtait 1 $ et 5 $. Sur le papier, c'est une baisse de prix d'un facteur dix, accompagnée d'une fenêtre de contexte passée de 200K à 1M de tokens et d'une limite de sortie doublée à 128K.
Sur le papier. En pratique, la baisse est plus modeste, il existe un palier de prix au milieu de cette fenêtre de 1M, et une route de classification qui tournait sans problème sur Haiku 4.5 peut se mettre à renvoyer des erreurs 400 le jour où vous changez l'identifiant du modèle. Nous avons écrit cet article pour les équipes qui font tourner de l'IA à fort volume (triage, extraction, routage, sous-agents) et veulent savoir où le modèle économique suffit, et où il ne suffit pas. Tous les prix et comportements de l'API ci-dessous proviennent de la documentation officielle d'Anthropic au moment du lancement. Lorsque nous faisons des hypothèses, nous le disons.
Les chiffres qui comptent
| Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 | Opus 5.5 | |
|---|---|---|---|---|
| Contexte / sortie max | 1M / 128K | 200K / 64K | 1M / 128K | 1M / 128K |
| Entrée / sortie ($ par MTok) | 0,10 / 0,50 (prompt ≤ 100K) | 1 / 5 | 2 / 10 | 4 / 20 |
| Entrée / sortie au-delà de 100K de prompt | 0,50 / 2,50 | tarif unique | tarif unique | tarif unique |
| Lecture du cache ($ par MTok) | 0,01 | 0,10 | 0,10 | 0,20 |
| Réflexion (thinking) | adaptative, activée par défaut | budget manuel, désactivée par défaut | adaptative, activée par défaut | toujours active |
| Effort par défaut | medium | n/a | high | medium |
temperature / top_p / top_k |
valeurs par défaut uniquement | autorisés | valeurs par défaut uniquement | supprimés |
| Prefill de l'assistant | 400 | autorisé | 400 | 400 |
Le modèle est disponible sur l'API Claude sous le nom claude-haiku-5-5, sur Amazon Bedrock sous anthropic.claude-haiku-5-5, et sur Google Cloud, Microsoft Foundry et Claude Platform on AWS sous l'identifiant simple. La lecture du cache coûte 0,1× le tarif d'entrée, les écritures de cache de cinq minutes 1,25× et celles d'une heure 2×, soit les mêmes multiplicateurs que le reste de la gamme.
Pourquoi « dix fois moins cher » signifie plutôt 7,7×
La première chose que dit le guide de migration, quelques paragraphes plus loin, c'est que Haiku 5.5 utilise un nouveau tokenizer et que le même texte compte pour environ 30 % de tokens en plus que sur Haiku 4.5. Le prix par token a été divisé par dix, mais vous payez désormais 1,3 token là où vous en payiez un. Dix divisé par 1,3 donne environ 7,7. C'est toujours une baisse très importante, mais c'est ce chiffre qu'il faut mettre dans un budget, pas 10×.
La deuxième chose qui fait bouger la facture, c'est la réflexion. Haiku 4.5 ne raisonnait que lorsque vous le lui demandiez, avec un budget de tokens manuel. Haiku 5.5 applique par défaut une réflexion adaptative, à l'effort medium, sur chaque requête qui ne précise pas le contraire. Les tokens de réflexion sont facturés comme des tokens de sortie. Sur un prompt de classification qui renvoyait auparavant un seul mot, vous pouvez maintenant payer quelques centaines de tokens de raisonnement avant ce mot. Le remède est simple : réglez output_config.effort sur low pour les routes simples, où le modèle réfléchit moins et peut même s'en passer entièrement sur les entrées faciles. Mais il faut le faire volontairement, car la valeur par défaut ne le fera pas à votre place.
Le palier de prix à 100K tokens
C'est le détail que nous aimerions que chaque équipe voie avant de concevoir quoi que ce soit autour du contexte de 1M. Haiku 5.5 a deux grilles tarifaires, choisies selon la longueur du prompt. Jusqu'à 100K tokens de prompt, vous payez 0,10 $ / 0,50 $. Au-delà de 100K, vous payez 0,50 $ / 2,50 $, soit cinq fois plus, et la documentation précise qu'il s'agit du tarif de la requête entière, pas seulement des tokens au-delà du seuil.
Un prompt de 99K tokens coûte environ un centime. Un prompt de 101K tokens en coûte environ cinq. Pour une seule requête, ce n'est rien. Pour un pipeline qui en envoie un million par mois, c'est la différence entre 10 000 $ et 50 000 $ rien qu'en entrée. Nous n'avons pas vu le seuil détaillé pour les prompts composés en majorité de lectures de cache ; considérez donc que la partie en cache compte dans les 100K tant que votre facture ne dit pas le contraire.
Concrètement : la fenêtre de 1M est bien réelle, mais elle est tarifée pour un usage occasionnel. Pour une route à fort volume, concevez en restant sous 100K. Une récupération qui ramène les cinq extraits pertinents plutôt que le manuel entier, des historiques de conversation compactés, des sorties d'outils réduites avant d'être renvoyées au modèle. Si une route a réellement besoin de 300K tokens de contexte à chaque appel, elle n'est plus une route Haiku sur le plan du prix, et Sonnet 5.5 à 2 $ tarif unique peut revenir à un coût proche.
À quoi sert Haiku 5.5
Anthropic le positionne pour « les tâches à fort volume et sensibles à la latence comme la classification, le routage, l'extraction et les sous-agents », et affirme qu'il est nettement meilleur que Haiku 4.5 pour suivre les instructions et fonctionner comme sous-agent. D'après le travail que nous menons pour nos clients, voici les routes où nous l'essaierions en premier :
- Triage de tickets et d'e-mails. Catégorie, priorité, langue, nécessité ou non qu'un humain le voie. Entrée courte, réponse structurée, des millions d'appels.
- Extraction vers un schéma. Factures, CV, contrats, formulaires. Avec les sorties structurées, le modèle ne peut pas renvoyer un JSON mal formé, ce qui compte ici plus que l'intelligence brute.
- Routage en amont d'un modèle plus puissant. Haiku décide si une question relève d'une réponse de FAQ, d'une requête en base de données, ou de quelque chose qui demande Sonnet ou Opus.
- Sous-agents de lecture intensive. Dans un agent qui doit parcourir cinquante fichiers ou une centaine de pages web, le modèle coûteux n'a pas besoin de tout lire. Un worker Haiku lit et résume, le modèle principal décide.
- Synthèse de logs et d'événements. Transformer une nuit de bruit CloudWatch en cinq lignes qu'une personne lira vraiment.
- Modération et détection de données personnelles avant que le texte ne soit stocké ou transmis plus loin.
Là où nous ne l'utiliserions pas : les longues sessions de code agentique, les grosses refontes, la recherche en plusieurs étapes où la requête suivante dépend du jugement porté sur la précédente, et tout ce qui rend une mauvaise réponse coûteuse et difficile à détecter. C'est le rôle de Sonnet 5.5 et d'Opus 5.5, et nous examinons cette frontière dans la comparaison Opus 5.5 vs Fable 5.1.
Une vraie comparaison de coûts
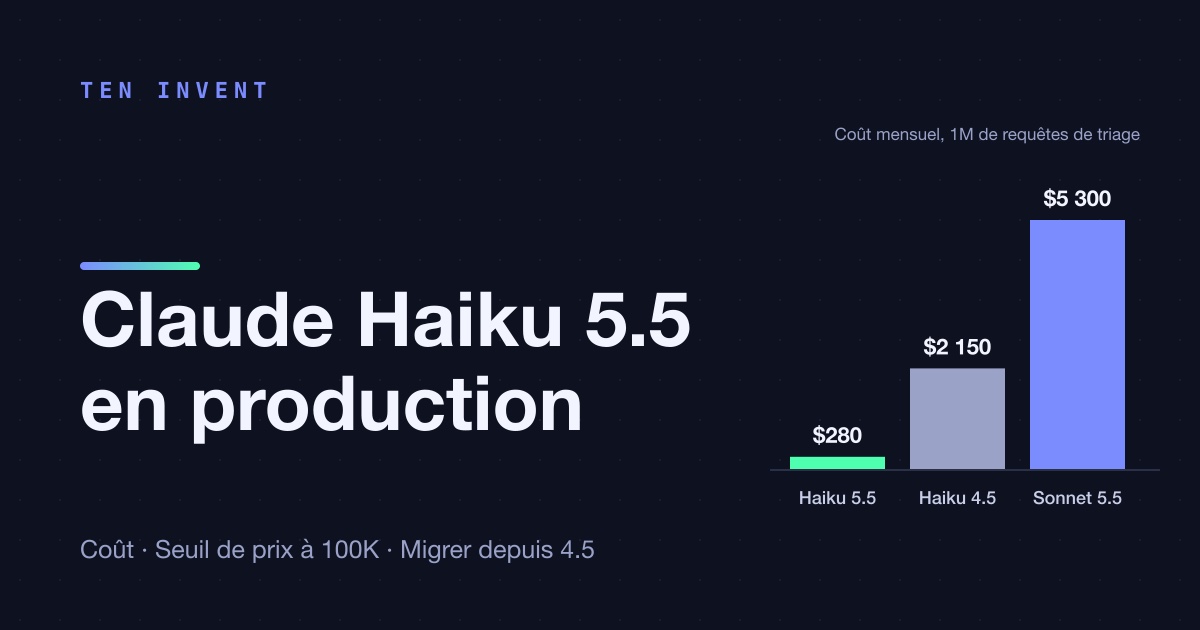
Chiffrons une route concrète : le triage de tickets à un million de requêtes par mois. Chaque requête comporte un préfixe de 3 000 tokens identique à chaque fois (prompt système, définitions des catégories, quelques exemples), donc servi depuis le cache. Puis 1 000 tokens d'entrée fraîche, le ticket lui-même, et 300 tokens de sortie, réflexion à l'effort low comprise. Nous supposons le même nombre de tokens pour les modèles 5.5 et nous divisons par 1,3 pour Haiku 4.5, comme l'indique la note sur le tokenizer. Les écritures de cache sont ignorées, car à ce volume le préfixe reste chaud.
Par requête, cela donne 0,00028 $ sur Haiku 5.5, 0,0053 $ sur Sonnet 5.5 et 0,0106 $ sur Opus 5.5. Haiku 5.5 est environ 19 fois moins cher que Sonnet et 38 fois moins cher qu'Opus sur ce profil. Remarquez où va l'argent : sur Haiku 5.5, plus de la moitié du coût vient de la sortie, si bien que le réglage de l'effort pèse plus sur la facture que la longueur du prompt. Doublez la réflexion et vous doublez presque le coût.
Une mise en garde avant que quiconque ne construise une cascade à trois niveaux sur la foi d'un graphique comme celui-ci. Les conseils de coûts d'Anthropic eux-mêmes recommandent de mesurer d'abord l'option plus simple : le modèle plus puissant à un effort plus bas sur les mêmes tâches. Une cascade a des coûts cachés. Les caches sont propres à chaque modèle, donc chaque escalade repaie son préfixe. Une mauvaise réponse du modèle économique qui est repérée plus tard coûte une nouvelle tentative sur le modèle coûteux, et une mauvaise réponse qui n'est pas repérée coûte plus cher que n'importe quel token. Jugez le coût par tâche accomplie, pas par requête. Pour le triage et l'extraction, Haiku gagne généralement sur les deux plans. Pour tout ce qui demande du jugement, vérifiez avec vos propres évaluations.
Ruptures de compatibilité si vous venez de Haiku 4.5
Les prompts Haiku 4.5 existants devraient pour l'essentiel fonctionner, selon Anthropic. Le code de requête qui les entoure, peut-être pas. Voici les changements qui renvoient des erreurs ou modifient silencieusement la sortie :
budget_tokensrenvoie une erreur 400. La réflexion est uniquement adaptative. Remplacez le budget paroutput_config.effort.temperature: 0renvoie une erreur 400. Les paramètres d'échantillonnage doivent rester à leurs valeurs par défaut ;top_kest purement rejeté. Les routes de classification définissent presque toujourstemperature: 0, c'est donc la première chose qui casse. Contraignez plutôt la sortie avec des sorties structurées ou un enum dans un schéma d'outil.- Le prefill de l'assistant renvoie une erreur 400, même avec la réflexion désactivée. Si vous utilisiez un prefill pour forcer du JSON, passez aux sorties structurées. Si c'était pour éviter un préambule, dites-le dans le prompt système.
- La réflexion compte dans
max_tokens. Unmax_tokens: 50dimensionné pour une étiquette d'un mot peut être entièrement consommé par la réflexion, et vous obtenezstop_reason: "max_tokens"sans aucun texte. Laissez de la marge, environ 1 000 tokens sur une route courte, ou baissez l'effort. - Le premier bloc de contenu peut être de type
thinking. Le code qui litresponse.content[0].textcasse. Lisez les blocs par type. - Les classifieurs de sécurité peuvent refuser une requête, et sur Haiku 5.5 il n'y a pas de repli côté serveur vers un autre modèle. Gérez
stop_reason: "refusal"dans votre propre code. - Les blocs de réflexion sont liés au compte et à la conversation. Renvoyez-les tels quels avec les résultats d'outils et ne modifiez pas les tours précédents.
Il reste possible de désactiver la réflexion avec thinking: {type: "disabled"}, mais uniquement aux efforts low, medium ou high, et la documentation est assez claire : baisser l'effort est le meilleur levier.
À quoi cela ressemble en code
Voici à peu près ce que nous plaçons devant une boîte de support, en TypeScript, avec un schéma Zod pour que la réponse ne puisse pas revenir mal formée :
import Anthropic from "@anthropic-ai/sdk";
import { z } from "zod";
import { zodOutputFormat } from "@anthropic-ai/sdk/helpers/zod";

const Triage = z.object({
  category: z.enum(["billing", "bug", "how-to", "account", "other"]),
  priority: z.enum(["low", "normal", "urgent"]),
  needs_human: z.boolean(),
});

const client = new Anthropic();

export async function triage(ticket: string) {
  const response = await client.messages.parse({
    model: "claude-haiku-5-5",
    max_tokens: 1024, // room for thinking plus the answer
    output_config: {
      effort: "low",
      format: zodOutputFormat(Triage),
    },
    system: [
      { type: "text", text: TRIAGE_RULES, cache_control: { type: "ephemeral" } },
    ],
    messages: [{ role: "user", content: ticket }],
  });

  if (response.stop_reason === "refusal") return null; // no server-side fallback on Haiku
  return response.parsed_output;
}
Trois détails portent l'essentiel de la valeur. Les règles se trouvent dans un bloc système mis en cache, si bien que le préfixe de 3 000 tokens coûte un dixième du prix d'entrée. L'effort est réglé explicitement sur low, parce que la valeur par défaut est medium. Et il n'y a aucun temperature nulle part, parce qu'en envoyer un est désormais une erreur.
Notre recommandation
Si vous avez une route à fort volume sur Haiku 4.5, migrez-la. Même après prise en compte du tokenizer, le prix est divisé par environ 7,7, le modèle suit mieux les instructions, et les changements de code prennent un après-midi si vous parcourez la liste ci-dessus. Si vous avez une route sur Sonnet qui ne fait que classer ou extraire, faites-la tourner sur Haiku 5.5 face à vos évaluations. Sur notre exemple, l'économie est de 95 %, et pour ce type de travail l'écart de qualité est souvent plus faible qu'on ne le croit.
Deux règles pour que cela reste économique : restez sous 100K tokens par prompt, et réglez l'effort explicitement sur chaque route. Et si vous souhaitez un regard extérieur sur la destination réelle de votre facture d'IA, c'est un travail que nous réalisons pour nos clients.