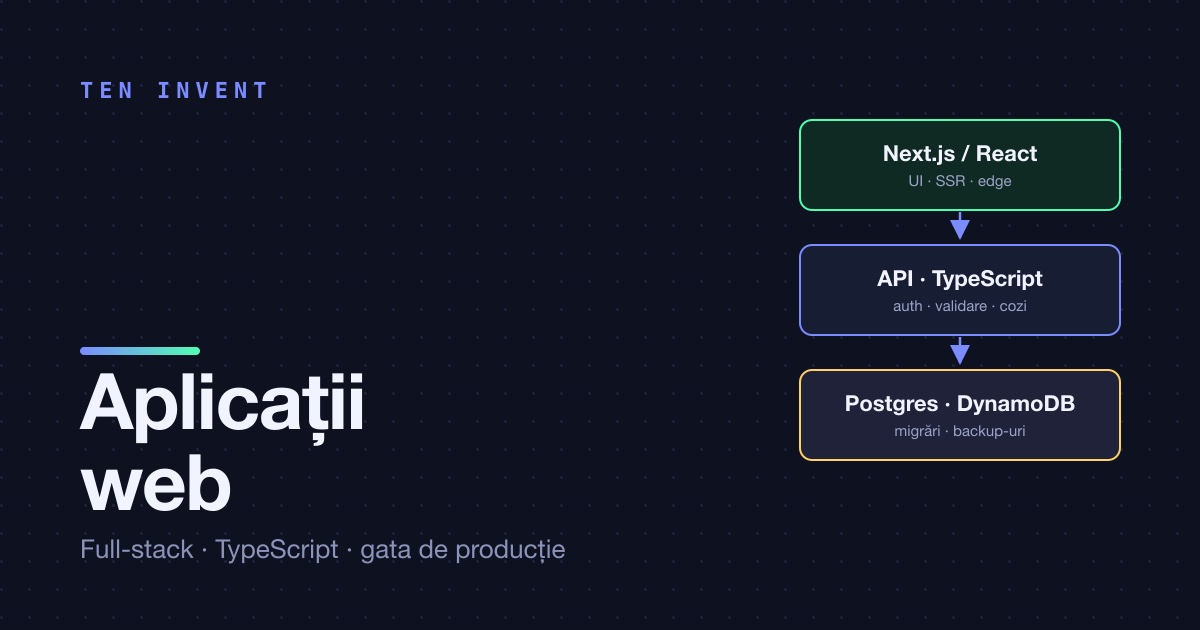
Anul acesta am livrat două platforme web foarte diferite cu aceeași metodă. Una este o platformă de magazine online multi-tenant pentru un grup de retail din România: Laravel, o bază de date per tenant, trei panouri de administrare, un shop public pentru fiecare brand. Cealaltă este o platformă de parteneri și plăți pentru un client din SUA: trei aplicații Next.js pe AWS App Runner, un API în TypeScript, DynamoDB și PostgreSQL una lângă alta, cu bani care trec prin ea în fiecare lună.
Stack-uri diferite, țări diferite, bugete diferite. Felul în care le construim este identic, și despre asta e articolul. Nu „suntem agili” și nu o listă de unelte, ci ce se întâmplă concret în primele trei săptămâni și la ce se poate aștepta clientul în anul de după.
Săptămâna 0: un discovery care se termină cu un repository
Majoritatea brief-urilor pe care le primim sunt un paragraf și un deadline. Discovery-ul înseamnă una sau două săptămâni plătite care transformă acel paragraf în trei lucruri: un model de date, o listă de medii și un prim milestone suficient de mic încât să fie real.
Modelul de date este partea pe care oamenii o subestimează. La platforma de magazine, decizia ca fiecare tenant să aibă propria bază de date a fost luată în discovery, pe o tablă, după o singură întrebare: va avea vreodată un tenant nevoie să plece cu datele lui? Răspunsul a fost da, deci izolarea trebuia să fie fizică, nu o coloană tenant_id. Acea singură decizie a modelat configurarea ORM-ului, panourile de administrare, strategia de backup și pagina de prețuri.
La platforma de parteneri, întrebarea echivalentă a fost: care tipare de acces sunt fixe pentru totdeauna? Căutările de comenzi după partener și lună nu se schimbă niciodată, așa că au mers în DynamoDB cu un design single-table. Tot ce seamănă cu raportare, unde întrebările se schimbă în fiecare trimestru, a mers în PostgreSQL. Am scris despre alegerea aceea în DynamoDB single table sau Postgres: cum am ales.
Discovery-ul se termină când există un repository cu un README, un stack CDK gol (sau un schelet Laravel) și un milestone pe care clientul îl poate descrie într-o propoziție. Dacă se termină cu un slide deck, a fost o întâlnire de vânzări.
Săptămâna 1: scheletul e în producție înaintea primei funcționalități
Primul lucru pe care îl construim nu e o funcționalitate. E rama plictisitoare de care va atârna fiecare funcționalitate: autentificare, roluri, cele trei medii, un pipeline CI care face deploy la merge și un mediu de preview per pull request. La finalul primei săptămâni există un URL în care clientul se poate loga. Nu face nimic util încă, și exact asta e ideea: fiecare bucată de instalație care ar putea întârzia o lansare a fost deja exersată.
Pentru platforma de parteneri asta a însemnat un codebase CDK cu trei conturi AWS și GitHub Actions făcând deploy prin roluri OIDC, fără chei permanente nicăieri. Am descris configurația în trei conturi AWS, un singur codebase CDK. Pentru platforma de magazine a însemnat un schelet Laravel cu pachetul de tenancy legat, un panou de super-admin, un panou de workspace per tenant și un script de deploy care creează o bază de date de tenant dintr-o singură comandă.
Motivul pentru care insistăm pe ordinea asta e simplu: în schelet locuiesc surprizele. Configurația de build versus runtime în Next.js, domeniile de cookie între subdomenii, un health check care raportează „sănătos” în timp ce baza de date e inaccesibilă. Preferăm să le întâlnim în prima săptămână, pe o pagină care spune „hello”, decât în săptămâna lansării.
Alegerea stack-ului: TypeScript implicit, Laravel când merită
Suntem o echipă TypeScript-first. Un API Node.js, un frontend React sau Next.js și PostgreSQL împart un singur limbaj, un singur linter, un singur test runner și un singur reviewer. Pentru o echipă de doi-trei oameni asta e un avantaj real de viteză, iar contractele tipate între frontend și backend elimină o întreagă clasă de bug-uri înainte să existe.
Folosim Laravel când proiectul i se potrivește mai bine, și platforma de magazine i se potrivea. Avea nevoie de trei panouri de administrare cu zeci de ecrane CRUD, baze de date per tenant, cozi, job-uri programate și un strat de conținut în stil CMS. Laravel cu Filament ne-a dat panourile de administrare în zile în loc de săptămâni, iar pachetul de tenancy a rezolvat comutarea între baze de date, migrările per tenant și izolarea asset-urilor fără să scriem noi un framework. Alegerea Next.js acolo ar fi însemnat să construim un framework de administrare înainte să construim produsul.
Regula pe care o aplicăm: alege stack-ul care face al doilea an ieftin, nu primul demo rapid. Apoi scrie motivul, ca nimeni să nu-l redeschidă în luna a șasea.
Date: plictisitor implicit, exotic cu intenție
PostgreSQL e implicit. E baza de date pe care o va înțelege oricine moștenește sistemul și duce întrebările de raportare pe care nimeni nu le putea prezice în discovery. Apelăm la DynamoDB doar când tiparele de acces sunt fixe, scara justifică asta și cineva din echipă e dispus să dețină designul single-table.
Două lecții de anul acesta merită transmise. Prima: când sunt bani la mijloc, blochează fiecare curs în momentul tranzacției. Platforma de parteneri convertește comenzi din mai multe valute; o versiune timpurie aplica cursul curent la momentul plății în loc de cursul de la data comenzii, iar un partener a observat o diferență pe extrasul lui. Am corectat calculul, am refăcut istoricul, iar acum cursul e stocat pe rândul comenzii și nu se recalculează niciodată. A doua: când folosești o bază de date printr-un API HTTP de date, așteaptă-te ca toate coloanele JSON să sosească drept string-uri. Un helper de cinci linii ne-a scutit de o duzină de apeluri JSON.parse împrăștiate și de bug-urile care vin cu ele.
Săptămânile 2–12: incremente pe care le poți vedea
Din săptămâna a doua, ritmul e fix. Fiecare pull request primește un mediu de preview, deci review-ul se face pe o aplicație care rulează, nu pe un diff. În fiecare vineri e un demo pe staging cu ce s-a schimbat săptămâna aceea. În fiecare luni clientul primește un raport de ore lucrate, per task, cu planul săptămânii următoare. Backlog-ul e al lui, îl reordonează oricând.
Aici își câștigă pâinea modelul orar, time-and-materials. Nu există un scop fix de apărat, așa că atunci când clientul platformei de parteneri a cerut la mijlocul proiectului un flux de date pe care analiștii lor să-l consume în unealta lor de BI, nu am deschis un change request. L-am estimat, l-au prioritizat și a fost livrat două săptămâni mai târziu.
Lucrurile care mușcă, și cum construim în jurul lor
Cereri de lungă durată. Platforma de parteneri exportă extrase ca CSV și XLSX. Prima versiune punea tot fișierul în memorie, iar proxy-ul din fața App Runner închidea conexiunea la 120 de secunde în lunile mari. Acum CSV-ul e trimis rând cu rând, ca conexiunea să nu stea niciodată inactivă, iar XLSX-ul e generat de un worker și livrat prin link. Am acoperit celelalte ciudățenii ale platformei în App Runner după șase luni.
Configurație de build versus runtime. Next.js încorporează variabilele publice la build. Un deploy care schimba doar o variabilă de mediu nu făcea nimic, și ne-a luat o după-amiază să înțelegem de ce. Acum build-ul își primește configurația explicit per mediu, iar scriptul de deploy refuză să refolosească un tag de imagine pentru o configurație diferită. Detalii în config de build vs runtime în Next.js pe containere.
Monorepo-uri care reconstruiesc totul. Trei aplicații și un pachet partajat într-un singur repository însemnau că fiecare commit reconstruia trei imagini. Am schimbat pipeline-ul să construiască doar ce s-a schimbat, ceea ce a tăiat timpul de CI cu mai mult de jumătate. Vezi monorepo: trei aplicații, construiește doar ce s-a schimbat.
Dezvoltare asistată de AI. Folosim Claude Code zilnic și scrie o parte reală din codul de rutină, teste și infrastructură. Nu decide modelul de date, granițele de securitate sau ce ajunge în producție; un inginer senior revizuiește fiecare linie. Am fost expliciți despre împărțire în ce a scris Claude Code din infrastructura noastră și ce am refuzat.
Anul de după
O aplicație web e un sistem care rulează, nu o livrare. Când faza de construcție se încheie, se întâmplă două lucruri. Predăm documentație de la care un inginer nou poate porni: note de arhitectură, decision records, runbook-ul și procedura de deploy. Iar clientul alege între o predare curată către propria echipă sau păstrarea noastră pentru câteva ore pe lună, ca să operăm și să extindem.
Ambele platforme de anul acesta au ales a doua variantă. Platforma de magazine primește module noi în fiecare lună, cel mai recent un modul de taxe pe produse și teme dinamice pentru administrare. Platforma de parteneri primește un flux săptămânal de corecții și funcționalități mici, triate din board-ul de tichete al clientului, fiecare verificată în producție înainte de a fi închisă. Inginerii sunt aceiași oameni care au făcut discovery-ul în săptămâna zero, și exact asta e ideea.
Dacă ai un produs de construit și vrei să fie făcut așa, vorbește cu noi. Prima discuție e gratuită; discovery-ul e locul unde pornește ceasul.