2025 übergab uns ein US-Kunde eine Business-Plattform, die sein Partnerprogramm betreibt: Onboarding, Produktlistings, monatliche Einnahmen, Auszahlungen in mehreren Währungen, und die täglichen Werkzeuge des Operations-Teams. Sie war kurz zuvor von einer Low-Code-Plattform auf einen individuellen TypeScript-Stack migriert worden. Hunderte Partnerdatensätze waren per Skript importiert worden. Das Datenmodell trug noch die Form des alten Tools. Releases waren selten, und jedes einzelne war ein kleines Ereignis.
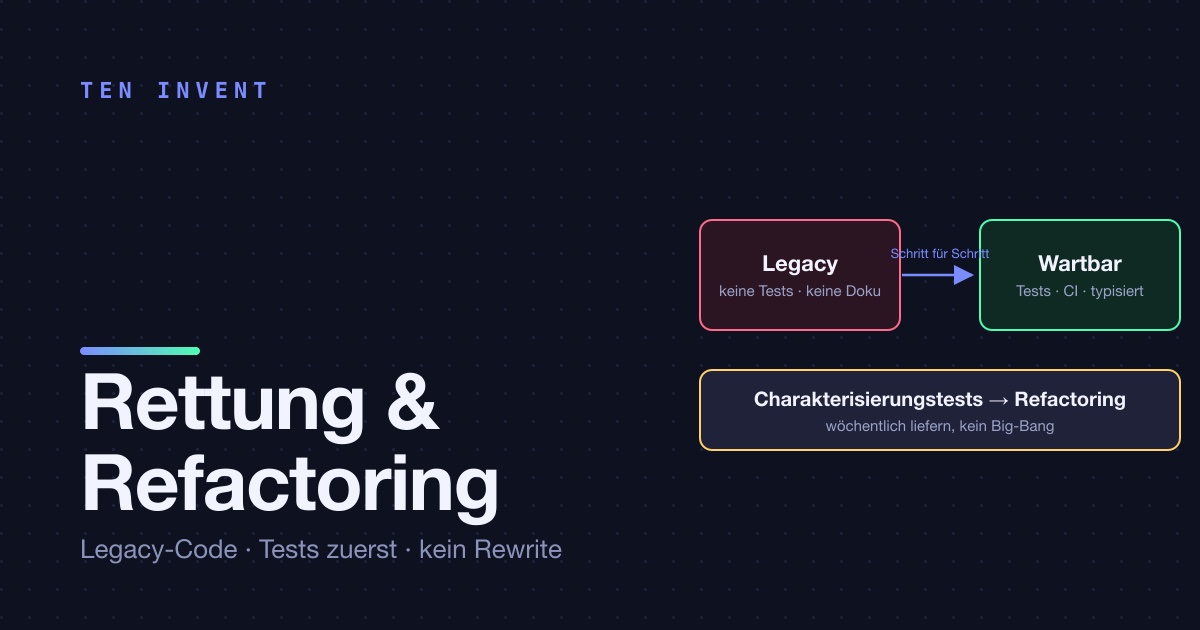
Ein Jahr später liefert dieselbe Plattform jede Woche kleine Änderungen aus, jede einzelne in Produktion verifiziert, bevor das Ticket geschlossen wird, und das Team, das darauf angewiesen ist, öffnet das Ticketboard statt eines E-Mail-Threads, wenn etwas verdächtig aussieht. Nichts wurde neu geschrieben. So sind wir von dem einen zum anderen gekommen, und das ist die Methode, die wir bei jeder Rettung anwenden.
Woche eins und zwei: alles lesen, nichts anfassen
Das Audit ist rein lesend. Zwei Wochen, in denen wir den Code, die Datenbank, die Infrastruktur und die Rechnung lesen und mit den Menschen sprechen, die das System täglich nutzen. Das Ergebnis ist eine Risikokarte: was zerbrechlich ist, was teuer ist, was in Ordnung ist, und in welcher Reihenfolge man sich darum kümmert.
Bei dieser Plattform war der erste Punkt auf der Karte kein technischer. Der Geldpfad, von einer Bestellung im E-Commerce-System bis zur monatlichen Abrechnung eines Partners, lief durch drei Services, zwei Datenbanken und eine Tabelle, die das Operations-Team nebenbei führte, „um zu prüfen". Niemand konnte mit Sicherheit sagen, dass die Abrechnung stimmte. Das wurde zur Priorität eins, noch vor der langsamen Admin-Seite und dem unzuverlässigen Deploy, denn eine falsche Auszahlung kostet Vertrauen, und Vertrauen ist das, was eine Rettung eigentlich wiederherstellt.
Der zweite Punkt war für den Kunden unsichtbar: Die Deploy-Pipeline verwendete denselben Image-Tag wieder, wenn sich nur die Konfiguration änderte, sodass manche Deploys stillschweigend nichts bewirkten. Der dritte war ein Stack, der sich dem CloudFormation-Ressourcenlimit näherte, was alle Infrastrukturänderungen im ungünstigsten Moment blockiert hätte.
Stabilisieren: beobachtbar machen, bevor es besser wird
Die ersten Änderungen sind nie Features. Es sind die Dinge, die es erlauben, das System sicher zu ändern: strukturierte Logs mit einer Request-ID, Traces über die drei Services hinweg, Alarme, die auf eine Runbook-Seite verweisen, und ein Backup, das mindestens einmal in ein Nicht-Produktionskonto wiederhergestellt wurde. Bei dieser Plattform haben wir außerdem einen Health-Check ersetzt, der „gesund" meldete, während die Datenbank unerreichbar war, und das Deploy so repariert, dass eine Konfigurationsänderung ein neues Image erzeugte (Deploy mit gleichem Tag und das Deploy-Skript ohne CI).
Danach die zwei oder drei Fixes, die den wöchentlichen Brand löschen. Hier war es der CSV-Export, der bei großen Monaten in Timeout lief, behoben durch zeilenweises Streamen der Datei, sodass der Proxy nie eine inaktive Verbindung schloss, und eine Admin-Seite, die zwanzig Sekunden brauchte, weil eine serverseitige Berechnung auf einer halben CPU lief. Keines von beiden ist glamourös. Beides war der Grund, warum das Operations-Team aufgehört hatte, dem Tool zu vertrauen.
Stabilisierung bedeutete auch einen Prozess. Jedes Problem landet mit einem klaren Status auf dem Ticketboard des Kunden; wir untersuchen, beheben auf dem Entwicklungsbranch, deployen in Produktion, verifizieren in Produktion mit echten Daten, und erst dann verschieben wir das Ticket in eine „Verify"-Spalte, damit der Kunde es bestätigt. Nichts wird auf Basis eines Unit-Tests geschlossen. Diese Spalte hat mehr für die Beziehung getan als jede technische Änderung.
Charakterisieren: festhalten, was das System tut, bevor man es ändert
Legacy-Code hat keine Tests, oder Tests, die beschreiben, was jemand sich erhofft hatte, dass er tut. Vor dem Refactoring schreiben wir Charakterisierungstests: Tests, die festhalten, was das System heute tut, an echten Daten, sodass jede spätere Änderung gegen die Realität geprüft wird statt gegen die Erinnerung.
Für den Geldpfad haben wir genau das gebaut, und es fand den Fehler, den die Nebentabelle des Operations-Teams verborgen hatte. Bestellungen kommen in mehreren Währungen an. Die Einnahmenberechnung wandte den Wechselkurs des Tages an, an dem die Abrechnung erstellt wurde, statt den Kurs vom Tag der Bestellung, sodass sich die Einnahmen eines Partners je nachdem änderten, wann jemand auf „erzeugen" klickte. Ein Partner bemerkte, dass die Zahl nicht mit seinen eigenen Aufzeichnungen übereinstimmte, und schrieb uns.
Die Lösung war konzeptionell einfach: Der Kurs wird in dem Moment an der Bestellung festgehalten, in dem sie erfasst wird, und nie neu berechnet. Die Arbeit steckte in den Details: ein Helper für JSON-Spalten, die als Strings aus der HTTP-Daten-API der Datenbank ankommen, ein Backfill, das die Historie mit den korrekten Kursen neu berechnete und dabei einen Audit-Trail der Änderungen führte, ein Vergleich jeder Abrechnung vorher und nachher, und eine Verifizierung in Produktion gegen die eigenen Zahlen des Partners. Drei verwandte Probleme, die von der Finanzleitung des Kunden gemeldet wurden, wurden in derselben Woche behoben und verifiziert. Die Charakterisierungstests laufen jetzt bei jedem Pull Request, und die Nebentabelle ist verschwunden.
Refactoring entlang der Nahtstellen, nie in einem Branch namens „v2"
Mit Observability, Backups und Tests an ihrem Platz wird Refactoring zur gewöhnlichen Arbeit. Wir refaktorieren entlang der Nahtstellen, die zählen: die Pfade, die das nächste Feature blockieren, die Pfade, die Leute nachts aufwecken, die Pfade, die ein neuer Engineer nicht lesen kann. Nie ein Big-Bang-Branch, der drei Monate lang divergiert.
Bei dieser Plattform waren die Nahtstellen die aus dem alten Tool importierten Daten. Hunderte Partnerprofile trugen Felder, die vom Modell der Low-Code-Plattform geformt waren, und mehrere hundert weitere kamen später über drei verschiedene Import-Skripte hinzu. Wir haben pro Feld eine Single Source of Truth geschaffen, mehr als tausend Profile daraus nachträglich befüllt und die Skripte gelöscht. Eine Charge von Partnercodes war mit einem angehängten Bindestrich erstellt worden und hatte doppelte Landing-Collections im E-Commerce-System erzeugt; wir haben neunundvierzig Duplikate entfernt und siebenundzwanzig Codes bereinigt, und eine Handvoll mit nicht-lateinischen Zeichen bewusst unangetastet gelassen, weil die Kosten des Anfassens den Nutzen überstiegen hätten. Ein Race zwischen zwei Writern auf einem sekundären Index in DynamoDB wurde mit einem bedingten Write behoben.
Feature-Flags erledigten den Rest. Ein Produkttyp, der nicht mehr erstellt werden sollte, bekam einen Kill-Switch in der Konfiguration statt einer Codelöschung, damit das Operations-Team ihn wieder aktivieren konnte, falls ein Kunde danach fragte. Jedes Refactoring wurde hinter einem Flag ausgeliefert oder in einer Form, die mit einem Deploy rückgängig gemacht werden konnte.
Modernisieren, sobald es sicher ist, etwas zu ändern
Modernisierung ist die letzte Phase, nicht die erste, denn sie ist erst sicher, sobald das System beobachtet, gesichert und getestet werden kann. Hier bedeutete das Infrastruktur: Die Stacks wurden aufgeteilt, bevor sie das CloudFormation-Limit erreichten (CloudFormation-Limit von 500 Ressourcen: einen Stack aufteilen), das Container-Rollout wanderte in den CDK-Deploy statt in einen separaten CLI-Schritt, jede Umgebung bekam ihre eigenen benutzerdefinierten Domains, und die Deploy-Pipeline hörte auf, drei Anwendungen neu zu bauen, wenn sich eine Datei änderte. Framework-Versionen wurden einen Major nach dem anderen aktualisiert, jeweils abgesichert durch die Charakterisierungstests.
Bei anderen Rettungen war diese Phase ein PHP- und Laravel-Versionssprung über fünf Majors, eine Migration von MySQL zu PostgreSQL mit einer Dual-Write-Periode ohne Ausfallzeit (Zero Downtime ist eine Frage der Schema-Migrationsdisziplin), oder ein Umzug von einem einzelnen, handgebauten Server zu Containern und Infrastructure as Code. Die Reihenfolge ist immer dieselbe, und das System läuft währenddessen durchgehend weiter.
Wenn die Antwort lautet: „Diesen Teil neu schreiben"
Manchmal ist das so. Ein Rewrite ist gerechtfertigt, wenn das Domänenmodell grundlegend falsch für das ist, was das Geschäft heute tut, oder wenn die darunterliegende Plattform tot ist. Selbst dann lautet die ehrliche Antwort meist „diesen Teil neu schreiben", nicht „alles neu schreiben": das Modul herausschneiden, hinter eine Schnittstelle stellen, ersetzen, den Rest behalten. Das Audit sagt schriftlich, mit Begründung, welcher Fall vorliegt. Wir haben dieses Jahr einmal „neu schreiben" gesagt und viele Male „nicht neu schreiben", und wir verkaufen den Rewrite nicht, weil wir dafür nicht anders abrechnen.
Wenn Sie ein System haben, das sich niemand traut zu deployen, oder ein Angebot eines Anbieters für einen kompletten Rewrite, zu dem Sie eine zweite Meinung möchten, schicken Sie es uns. Das Audit dauert zwei Wochen, ist rein lesend, und die Risikokarte gehört Ihnen, wofür auch immer Sie sich entscheiden.