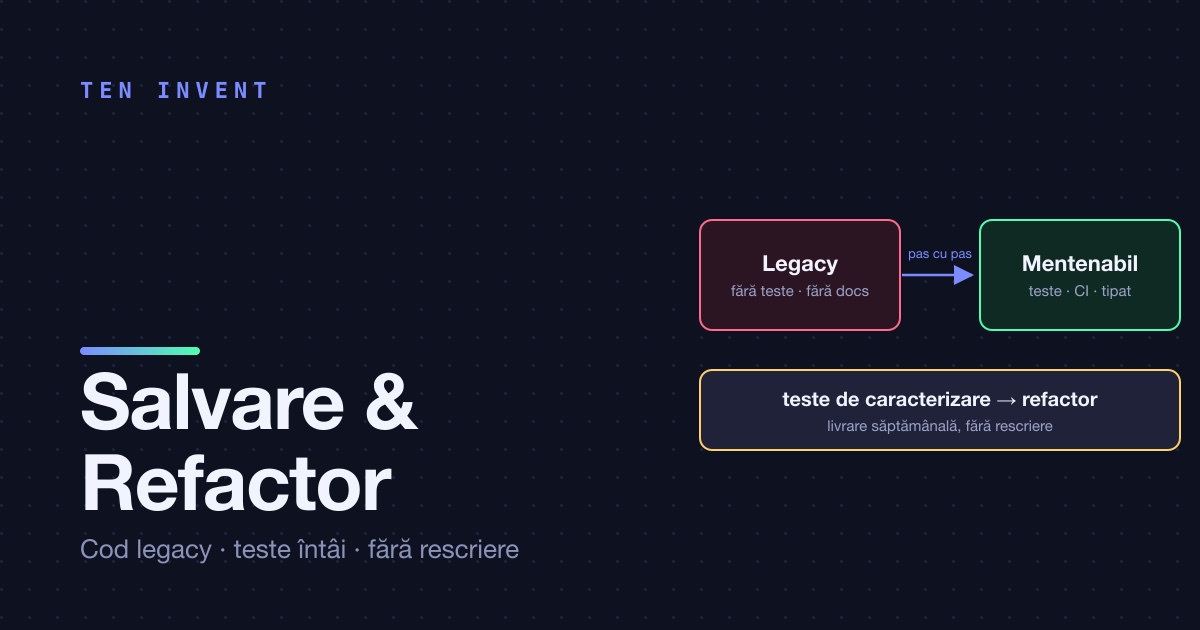
În 2025 un client din SUA ne-a predat o platformă de business care îi rulează programul de parteneri: onboarding, listări de produse, câștiguri lunare, plăți în mai multe valute și uneltele zilnice ale echipei de operațiuni. Fusese recent migrată de pe o platformă low-code pe un stack TypeScript custom. Sute de înregistrări de parteneri fuseseră importate prin script. Modelul de date avea încă forma vechii unelte. Lansările erau rare și fiecare era un mic eveniment.
Un an mai târziu, aceeași platformă livrează schimbări mici în fiecare săptămână, fiecare verificată în producție înainte ca tichetul să fie închis, iar echipa care depinde de ea deschide board-ul de tichete, nu un fir de email, când ceva pare în neregulă. Nimic nu a fost rescris. Așa am ajuns de la una la cealaltă, și e metoda pe care o aplicăm la fiecare salvare.
Săptămânile unu și doi: citește tot, nu atinge nimic
Auditul e read-only. Două săptămâni în care citim codul, baza de date, infrastructura și factura, și vorbim cu oamenii care folosesc sistemul în fiecare zi. Rezultatul e o hartă de riscuri: ce e fragil, ce e scump, ce e în regulă și în ce ordine ne ocupăm de ele.
Pe această platformă, primul element de pe hartă nu a fost unul tehnic. Traseul banilor, de la o comandă în sistemul de e-commerce până la extrasul lunar al unui partener, trecea prin trei servicii, două baze de date și un tabel pe care echipa de operațiuni îl ținea pe lângă „ca să verifice”. Nimeni nu putea spune cu certitudine că extrasul e corect. Asta a devenit prioritatea unu, înaintea paginii lente de administrare și a deploy-ului capricios, pentru că o plată greșită costă încredere, iar încrederea e lucrul pe care îl restaurează de fapt o salvare.
Al doilea element era invizibil pentru client: pipeline-ul de deploy refolosea un tag de imagine când se schimba doar configurația, așa că unele deploy-uri nu făceau nimic în tăcere. Al treilea era un stack care se apropia de limita de resurse din CloudFormation, ceea ce ar fi blocat toate schimbările de infrastructură în cel mai prost moment posibil.
Stabilizare: fă-l observabil înainte să-l faci mai bun
Primele schimbări nu sunt niciodată funcționalități. Sunt lucrurile care îți permit să schimbi sistemul în siguranță: loguri structurate cu un ID de cerere, trace-uri prin cele trei servicii, alerte care corespund unei pagini de runbook și un backup care a fost restaurat măcar o dată într-un cont de non-producție. Pe această platformă am înlocuit și un health check care raporta „sănătos” în timp ce baza de date era inaccesibilă, și am reparat deploy-ul astfel încât o schimbare de configurație să producă o imagine nouă (deploy cu același tag și scriptul de deploy fără CI).
Apoi cele două-trei reparații care opresc incendiul săptămânal. Aici a fost exportul CSV care expira în lunile mari, reparat prin trimiterea fișierului rând cu rând, ca proxy-ul să nu închidă niciodată o conexiune inactivă, și o pagină de administrare care dura douăzeci de secunde pentru că un calcul pe server rula pe jumătate de CPU. Niciuna nu e spectaculoasă. Ambele erau motivul pentru care echipa de operațiuni încetase să aibă încredere în unealtă.
Stabilizarea a însemnat și un proces. Fiecare problemă merge pe board-ul de tichete al clientului cu un status clar; investigăm, reparăm pe branch-ul de dezvoltare, facem deploy în producție, verificăm în producție cu date reale și abia apoi mutăm tichetul într-o coloană „de verificat” pentru confirmarea clientului. Nimic nu se închide pe baza unui test unitar. Coloana aceea a făcut mai mult pentru relație decât orice schimbare tehnică.
Caracterizare: fixează ce face sistemul înainte să-l schimbi
Codul legacy nu are teste, sau are teste care descriu ce a sperat cineva că face. Înainte de refactorizare scriem teste de caracterizare: teste care surprind ce face sistemul azi, pe date reale, astfel încât fiecare schimbare ulterioară să fie verificată față de realitate, nu față de memorie.
Pentru traseul banilor am construit exact asta, și a găsit bug-ul pe care tabelul paralel al echipei de operațiuni îl ascundea. Comenzile sosesc în mai multe valute. Calculul câștigurilor aplica cursul de schimb din ziua în care era generat extrasul, în loc de cursul din ziua comenzii, așa că veniturile unui partener se schimbau în funcție de momentul în care cineva apăsa „generează”. Un partener a observat că cifra nu se potrivea cu propriile lui evidențe și a scris.
Reparația a fost conceptual simplă: cursul e capturat pe comandă în momentul înregistrării și nu se recalculează niciodată. Munca a fost în detalii: un helper pentru coloanele JSON care sosesc ca string-uri din API-ul HTTP de date al bazei, un backfill care a recalculat istoricul cu cursurile corecte păstrând o urmă de audit a ce s-a schimbat, o comparație a fiecărui extras înainte și după, și o verificare în producție față de cifrele proprii ale partenerului. Trei probleme conexe raportate de responsabilul financiar al clientului au fost reparate și verificate în aceeași săptămână. Testele de caracterizare rulează acum la fiecare pull request, iar tabelul paralel a dispărut.
Refactorizează de-a lungul cusăturilor, niciodată într-un branch numit „v2”
Cu observabilitate, backup-uri și teste la locul lor, refactorizarea devine muncă obișnuită. Refactorizăm de-a lungul cusăturilor care contează: căile care blochează următoarea funcționalitate, căile care trezesc oamenii noaptea, căile pe care un inginer nou nu le poate citi. Niciodată un branch big-bang care diverge trei luni.
Pe această platformă, cusăturile erau datele importate din vechea unealtă. Sute de profiluri de parteneri purtau câmpuri modelate după modelul platformei low-code, iar alte câteva sute fuseseră adăugate ulterior prin trei scripturi de import diferite. Am făcut o singură sursă de adevăr per câmp, am completat retroactiv peste o mie de profiluri din ea și am șters scripturile. Un lot de coduri de partener fusese creat cu o cratimă la final și generase colecții duplicate în sistemul de e-commerce; am eliminat patruzeci și nouă de duplicate și am normalizat douăzeci și șapte de coduri, și am lăsat deliberat neatinse câteva cu caractere non-latine, pentru că costul de a le atinge depășea beneficiul. O cursă între doi scriitori pe un index secundar în DynamoDB a fost reparată cu o scriere condiționată.
Feature flag-urile au făcut restul. Un tip de produs care nu mai trebuia creat a primit un kill switch în configurație în loc de o ștergere de cod, ca echipa de operațiuni să-l poată reactiva dacă cerea un client. Fiecare refactor a fost livrat în spatele unui flag sau într-o formă care putea fi revenită cu un singur deploy.
Modernizează odată ce e sigur să schimbi
Modernizarea e ultima fază, nu prima, pentru că e sigură doar odată ce sistemul poate fi observat, salvat și testat. Aici a însemnat infrastructură: stack-urile au fost împărțite înainte să atingă limita CloudFormation (limita de 500 de resurse din CloudFormation: împarte un stack), lansarea containerelor s-a mutat în interiorul deploy-ului CDK în loc de un pas CLI separat, fiecare mediu a primit propriile domenii custom, iar pipeline-ul de deploy a încetat să reconstruiască trei aplicații când se schimba un fișier. Versiunile de framework au fost actualizate câte o versiune majoră pe rând, fiecare în spatele testelor de caracterizare.
În alte salvări, faza asta a fost un salt de PHP și Laravel peste cinci versiuni majore, o migrare de la MySQL la PostgreSQL făcută cu o perioadă de dual-write și fără downtime (zero downtime e o disciplină de migrare a schemei) sau o mutare de la un singur server construit de mână la containere și infrastructură în cod. Secvența e mereu aceeași, iar sistemul rulează tot timpul.
Când răspunsul e „rescrie partea asta”
Uneori chiar e. O rescriere e justificată când modelul de domeniu e fundamental greșit pentru ce face acum business-ul sau când platforma de dedesubt e moartă. Chiar și atunci, răspunsul onest e de obicei „rescrie partea asta”, nu „rescrie tot”: decupează modulul, pune-l în spatele unei interfețe, înlocuiește-l, păstrează restul. Auditul spune care variantă, în scris, cu raționamentul. Am spus „rescrie” o dată anul acesta și „nu rescrie” de multe ori, și nu vindem rescrierea pentru că nu o facturăm diferit.
Dacă ai un sistem la care tuturor le e frică să facă deploy, sau o ofertă de la un furnizor pentru o rescriere completă la care ai vrea o a doua părere, trimite-ne-o. Auditul durează două săptămâni, e read-only, iar harta de riscuri e a ta, orice ai decide.