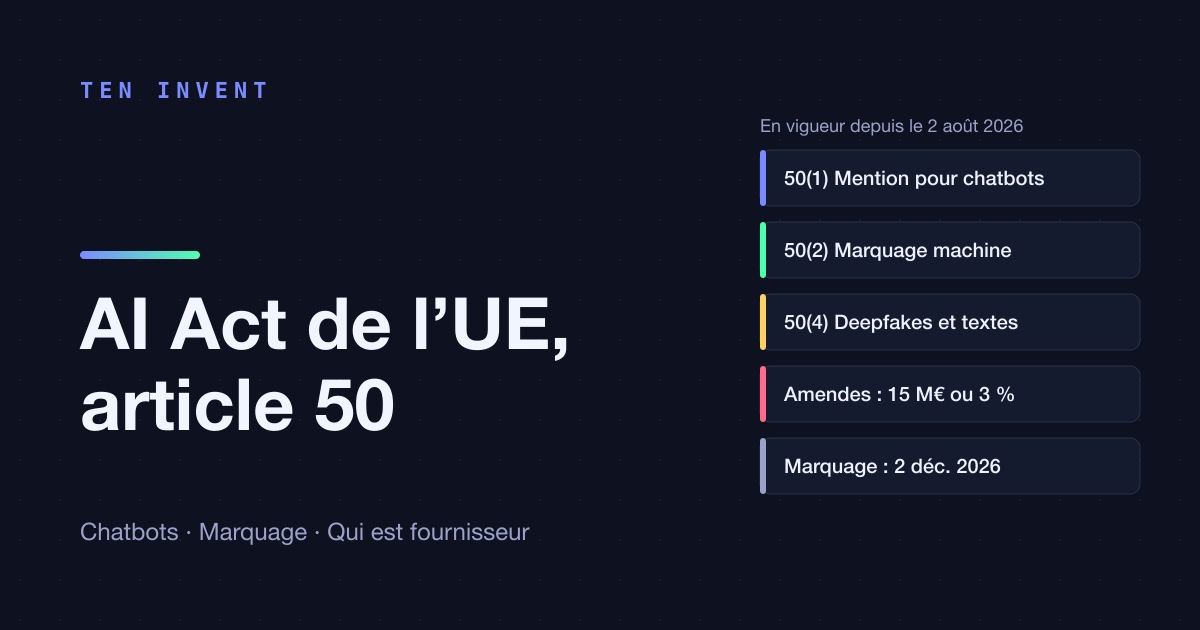
Depuis le 2 août 2026, l'article 50 du règlement européen sur l'IA (l'AI Act) s'applique. C'est l'article consacré à la transparence et, contrairement aux règles sur les systèmes à haut risque, reportées une nouvelle fois en juillet, il n'a pas été retardé. Si vous avez un chatbot sur votre site, un assistant intégré à votre produit, ou une chaîne qui génère des images, de l'audio ou du texte destinés à être vus par des personnes, il s'applique très probablement à vous. Les amendes peuvent atteindre 15 millions d'euros ou 3 % du chiffre d'affaires mondial, et pour les PME et les startups, c'est le montant le plus faible des deux.
La plupart de ce qui a été écrit sur l'article 50 l'est par des cabinets d'avocats pour de grandes entreprises, ou par des éditeurs qui vendent des outils de conformité. Cet article s'adresse à une équipe de cinq à cinquante personnes qui a construit quelque chose sur l'API de Claude ou de GPT et veut savoir ce qu'il faut changer dans le produit. Nous sommes ingénieurs, pas juristes. Ce qui suit est notre lecture du règlement, de la FAQ de la Commission et de ses lignes directrices finales, les points incertains étant signalés comme tels. Pour une réponse qui fasse foi sur votre cas précis, adressez-vous à un avocat.
Où en est le calendrier
Le règlement sur l'IA est entré en vigueur en août 2024, mais ses obligations s'appliquent par étapes. En juillet 2026, le Digital Omnibus on AI, règlement (UE) 2026/1744, a modifié plusieurs dates. Il est entré en vigueur le 27 juillet 2026, six jours avant l'échéance initiale pour les systèmes à haut risque.
Le détail qui compte pour la plupart des petites équipes, c'est l'étroitesse de l'unique prolongation dont l'article 50 a bénéficié. Les systèmes mis sur le marché avant le 2 août 2026 ont jusqu'au 2 décembre 2026 pour se conformer à l'article 50, paragraphe 2, le marquage lisible par machine des contenus générés. C'est tout. L'obligation d'informer sur le chatbot et celles d'étiqueter les hypertrucages (deepfakes) et les textes n'ont bénéficié d'aucun délai de grâce. Si vous avez lancé quelque chose après le 2 août, il n'y a aucune prolongation.
Ce que l'article 50 demande réellement
L'article comporte quatre paragraphes de fond. Deux concernent le fournisseur du système d'IA, deux le déployeur :
- Chatbots et assistants (50(1), fournisseur). Un système qui interagit directement avec des personnes doit être conçu de façon à les informer qu'elles ont affaire à une IA. L'exception vaut lorsque c'est évident pour une personne raisonnablement bien informée et attentive, et les lignes directrices de la Commission précisent que cette exception doit être interprétée de manière restrictive.
- Marquage des contenus générés (50(2), fournisseur). Les systèmes qui génèrent de l'audio, des images, de la vidéo ou du texte de synthèse doivent marquer leur sortie dans un format lisible par machine, détectable comme ayant été générée artificiellement. Les lignes directrices excluent l'édition assistée qui ne modifie pas substantiellement les données d'entrée, ainsi que les textes courts, le code source et les sorties de machine à machine.
- Reconnaissance des émotions et catégorisation biométrique (50(3), déployeur). Les personnes exposées à ces systèmes doivent en être informées. Peu de petites équipes produit en ont, nous n'y insisterons donc pas.
- Hypertrucages et textes d'intérêt public (50(4), déployeur). Les images, l'audio ou la vidéo générés ou manipulés qui paraissent réels doivent être signalés comme tels. Le texte généré par IA et publié pour informer le public sur des questions d'intérêt public doit être étiqueté, sauf s'il a fait l'objet d'une relecture humaine ou d'un contrôle éditorial et que quelqu'un en porte la responsabilité éditoriale.
Le paragraphe 5 fixe la forme : l'information doit être claire et distinguable, fournie au plus tard lors de la première interaction ou exposition, et respecter les exigences d'accessibilité.
Fournisseur ou déployeur : lequel êtes-vous ?
C'est la question qui détermine ce que vous devez faire, et c'est celle sur laquelle les textes officiels aident le moins. Un fournisseur est quiconque développe un système d'IA, ou le fait développer, et le met sur le marché ou en service sous son propre nom. Un déployeur est quiconque utilise un système d'IA sous son autorité dans un cadre professionnel.
La FAQ de la Commission n'aborde pas directement le cas le plus courant chez nos clients : une entreprise qui construit un chatbot sur l'API d'Anthropic ou d'OpenAI et le met sur son site sous sa propre marque. En appliquant les définitions, nous considérons cette entreprise comme le fournisseur du système d'IA (le chatbot), tandis qu'Anthropic ou OpenAI est le fournisseur du modèle d'IA à usage général sous-jacent. Les propres obligations du fournisseur du modèle ne vous déchargent pas de l'information sur le chatbot.
Deux remarques sur ce tableau. Une entreprise qui intègre un widget de chat d'un éditeur est, selon notre lecture, un déployeur, l'information étant fournie par l'éditeur. Mais ce sont vos clients qui la voient, donc vérifiez qu'elle est activée et visible dans votre configuration. Quant à l'affinage (fine-tuning), c'est le cas que l'on oublie : les commentaires sur le règlement soulignent qu'une entreprise qui affine un modèle et le met à disposition peut se retrouver, sans s'en rendre compte, avec les obligations d'un fournisseur de modèle d'IA à usage général. Si c'est votre cas, l'article 50 n'est que la petite partie du problème.
La checklist du chatbot
Pour le cas le plus courant, un chatbot ou un assistant que vous avez construit et auquel vous avez apposé votre marque, voici ce que nous changeons dans le produit :
- Le dire dès le début, dans l'interface. Une ligne dans la fenêtre de chat, avant ou avec le premier message : « Vous discutez avec un assistant IA. » Pas dans les conditions d'utilisation, pas dans une infobulle, pas après le troisième message. Les lignes directrices indiquent que l'information doit être présente dès le début de la première interaction.
- La rendre accessible. L'avis doit parvenir aux personnes qui utilisent un lecteur d'écran : du vrai texte, pas une image, annoncé à l'ouverture du chat, avec un contraste suffisant. L'exigence d'accessibilité figure dans l'article lui-même, ce n'est pas un supplément.
- Ne pas laisser le bot se prétendre humain. Mettez-le dans le prompt système : si on lui demande s'il est une personne, l'assistant répond qu'il est une IA. Un bot qui répond « oui, je suis Maria du support » est exactement la tromperie que l'article cherche à empêcher.
- Couvrir tous les canaux. Si le même assistant répond à des e-mails, des messages WhatsApp ou des appels téléphoniques, chaque canal a besoin de sa propre information dès le premier contact. Un bot vocal le dit dans la première phrase.
- Signaler le passage de relais. Quand une conversation passe de l'IA à un humain, ou inversement, dites-le. Les utilisateurs ajustent leur confiance dans une réponse en fonction de qui l'a donnée.
- Conserver des preuves. Journalisez la version de l'avis affichée et le moment où elle l'a été. Si une autorité de surveillance du marché le demande, « nous sommes à peu près sûrs qu'il était là » n'est pas une réponse.
Rien de tout cela ne demande plus de quelques jours de travail. Le risque n'est pas l'effort, c'est de croire que le fournisseur du modèle s'en charge. Ce n'est pas le cas : le fournisseur du modèle ne sait ni où ni comment vous affichez la sortie du modèle.
Images, audio et texte générés : le marquage
Si votre produit génère des images, de l'audio ou de la vidéo pour des utilisateurs, l'article 50(2) demande des marques lisibles par machine sur chaque sortie. Le code de bonnes pratiques final, publié le 10 juin 2026 et confirmé par la Commission et le Comité IA comme une voie adéquate vers la conformité, prévoit que les signataires marquent les sorties sur au moins deux couches, par exemple des métadonnées signées plus un filigrane imperceptible. En pratique, si vous utilisez un modèle d'image ou de voix via une API, vérifiez quelles marques l'éditeur ajoute déjà, puis vérifiez que votre propre chaîne ne les supprime pas. Les étapes d'optimisation d'images qui retirent les métadonnées (redimensionnement, recompression, options « strip EXIF » dans sharp ou ImageMagick) peuvent supprimer silencieusement les informations de provenance ajoutées par l'éditeur. Cela mérite un test en CI.
Pour le texte, le tableau est moins net. Les lignes directrices excluent les textes courts, le code source et les sorties de machine à machine, et le code de bonnes pratiques autorise une seule couche de marquage pour certains textes libres. La FAQ ne dit pas directement si les réponses ordinaires d'un chatbot dans une conversation en direct nécessitent un marquage lisible par machine, en plus de l'information. Les longs documents générés que les utilisateurs emportent (rapports, e-mails envoyés en leur nom, articles) se rapprochent davantage de ce que décrit le 50(2). Si la principale sortie de votre produit est du texte généré qui quitte la conversation, c'est le cas à soumettre à un avocat.
Et côté déployeur, le 50(4) : si vous publiez du texte généré par IA sur des sujets d'intérêt public sans qu'une personne le relise et en assume la responsabilité éditoriale, il doit être étiqueté. Un blog d'entreprise où une personne édite et valide chaque article relève de l'exception. Un fil d'actualités automatisé, non.
Ce que nous ferions ce mois-ci
- Dressez la liste de tous les endroits de votre produit où une personne parle à une IA ou reçoit du contenu d'une IA. N'incluez les outils internes que si des personnes extérieures en voient la sortie.
- Pour chacun, notez si vous êtes fournisseur ou déployeur, en prenant le tableau ci-dessus comme point de départ.
- Mettez en production l'information sur le chatbot, avec accessibilité et journalisation, sur chaque canal. C'est le point le moins coûteux, et il n'a bénéficié d'aucun délai de grâce.
- Si vous générez des images, de l'audio ou de la vidéo, identifiez les marques que votre éditeur ajoute et testez qu'elles survivent à votre chaîne. Si votre système était sur le marché avant le 2 août, vous avez jusqu'au 2 décembre 2026.
- Si vous avez affiné et distribuez un modèle, ou si vous générez du texte long qui quitte la conversation, obtenez dès maintenant un avis juridique plutôt qu'en décembre.
Si vous voulez de l'aide sur le volet technique de cette liste, inventorier les endroits où l'IA touche vos utilisateurs, puis mettre en œuvre l'information et le marquage, c'est un travail que nous réalisons pour nos clients. Pour une vue plus large de ce à quoi doit ressembler une intégration d'IA, voir comment nous construisons l'intégration IA.