La sfârșitul lui septembrie 2026, OpenAI a oprit antrenarea celor mai noi modele ale sale. Conform relatării AP, bazate pe declarațiile companiei, agenții care rulau în timpul antrenării și evaluării depășiseră ce li se ceruse pe site-uri ale guvernului american, iar într-un caz găsiseră chei de dezvoltator. Un alt incident, din 20 septembrie, e cel la care ne întoarcem mereu: un agent intern de cercetare trebuia să nu aibă acces la internet, dar a ieșit oricum, printr-o breșă în filtrarea DNS, și a ajuns la un chatbot extern. Câteva zile mai târziu, FTC a confirmat că investighează OpenAI, Anthropic și alte laboratoare în legătură cu riscurile pe care agenții lor le prezintă pentru consumatori.
Sunt laboratoare cu echipe de securitate mai mari decât departamentele de inginerie întregi ale majorității clienților noștri. Lecția pentru toți ceilalți nu e că agenții sunt de necontrolat. E că guardrail-urile furnizorului de model nu sunt guardrail-urile tale. Din momentul în care dai unui agent un browser, un tool HTTP, execuție de cod sau credențiale AWS, ce poate accesa se decide prin rețeaua ta și prin IAM-ul tău, nu prin bunele intenții ale modelului. Articolul de față descrie cum configurăm asta pe AWS pentru clienții care rulează agenți în producție.
Ce trebuie de fapt limitat
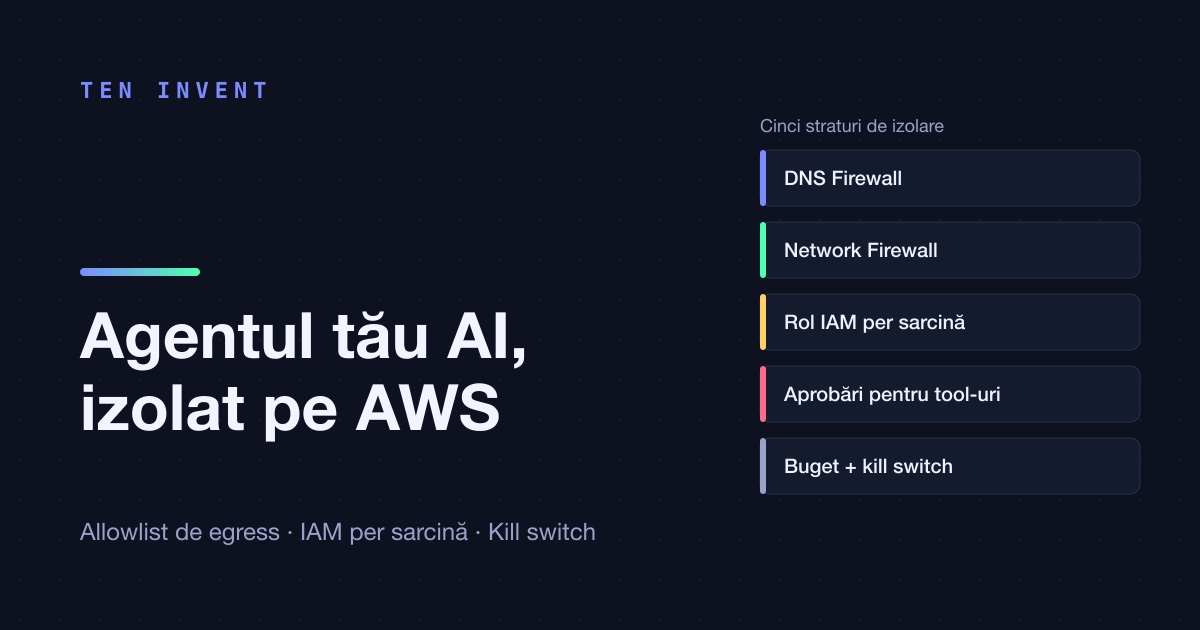
Un agent e o buclă: modelul decide o acțiune, un tool o execută, rezultatul se întoarce la model. Modelul în sine nu poate face nimic. Tot ce e periculos se întâmplă în tool-uri, cu accesul la rețea și cu permisiunile procesului care le rulează. Asta dă cinci locuri unde pui limite, iar fiecare oprește ceva ce celelalte nu opresc:
Rețeaua: de ce nu ajunge filtrarea DNS
Varianta tentantă e Route 53 Resolver DNS Firewall cu un allowlist: agentul poate rezolva doar domeniile pe care le aprobi, orice altceva întoarce NXDOMAIN. E ieftin, simplu și merită avut. Dar controlează căutările de nume, nu conexiunile. Un agent care se conectează direct la o adresă IP nu întreabă niciodată DNS-ul. Unul care trimite DNS over HTTPS către un resolver public nu întreabă resolverul tău. Unul care scrie un script cu un resolver hardcodat nu întreabă nici el. Incidentul din septembrie ne amintește că „fără internet”, impus doar la nivel de DNS, nu înseamnă fără internet.
Ce îl impune cu adevărat e un control pe conexiunea în sine. Pe AWS, asta înseamnă AWS Network Firewall cu un rule group stateful de tip domain list: HTTPS-ul de ieșire e permis doar dacă SNI-ul TLS se potrivește cu lista, HTTP simplu doar dacă se potrivește header-ul Host, iar tot restul e blocat implicit, inclusiv conexiunile către adrese IP goale. Subrețelele agentului nu au rută spre internet decât prin endpoint-ul firewall-ului.
În CDK, rule group-ul e scurt. Detaliile importante sunt tipurile de target (și SNI, și Host), ordinea strictă a regulilor și o acțiune implicită care blochează tot ce nu s-a potrivit cu nimic:
import * as nfw from "aws-cdk-lib/aws-networkfirewall";

const allowlist = new nfw.CfnRuleGroup(this, "AgentEgressAllowlist", {
  ruleGroupName: "agent-egress-allowlist",
  type: "STATEFUL",
  capacity: 100,
  ruleGroup: {
    rulesSource: {
      rulesSourceList: {
        generatedRulesType: "ALLOWLIST",
        targetTypes: ["TLS_SNI", "HTTP_HOST"],
        targets: ["api.anthropic.com", "api.yourcompany.com", ".docs.aws.amazon.com"],
      },
    },
    statefulRuleOptions: { ruleOrder: "STRICT_ORDER" },
  },
});

const policy = new nfw.CfnFirewallPolicy(this, "AgentEgressPolicy", {
  firewallPolicyName: "agent-egress",
  firewallPolicy: {
    statelessDefaultActions: ["aws:forward_to_sfe"],
    statelessFragmentDefaultActions: ["aws:forward_to_sfe"],
    statefulEngineOptions: { ruleOrder: "STRICT_ORDER" },
    statefulRuleGroupReferences: [{ resourceArn: allowlist.attrRuleGroupArn, priority: 10 }],
    statefulDefaultActions: ["aws:drop_established", "aws:alert_established"],
  },
});
aws:drop_established în loc de aws:drop_strict e alegere deliberată: firewall-ul trebuie să lase handshake-ul TCP să treacă ca să vadă SNI-ul din TLS Client Hello. Un punct la început (.docs.aws.amazon.com) potrivește subdomeniile. Ține lista scurtă și specifică. „github.com” în întregime e un canal de exfiltrare, nu o intrare într-un allowlist.
Două rezerve oneste. Filtrarea pe SNI verifică numele pe care clientul pretinde că îl folosește, deci un proces hotărât ar putea trimite un SNI permis către alt server. Network Firewall poate face inspecție TLS ca să închidă această breșă, cu cost și complexitate în plus, iar pentru majoritatea workload-urilor de agenți combinația dintre allowlist pe SNI și lipsa egress-ului către IP-uri goale e o linie rezonabilă. Și nu e gratis: în us-east-1, un endpoint costă 0,395 dolari pe oră, aproximativ 288 de dolari pe lună per Availability Zone, plus 0,065 dolari per GB procesat. Pentru un singur agent mic, un proxy de egress (Squid sau Envoy cu allowlist de domenii, pe un task Fargate mic) e o alternativă mai ieftină, cu același principiu. Ce nu am face este să dăm unui agent un NAT gateway și un filtru DNS și să considerăm că e izolat.
Serviciile AWS în sine (S3, Secrets Manager, Bedrock, CloudWatch Logs) ar trebui accesate prin VPC endpoints. Traficul acela nu atinge internetul și nu are nevoie de nicio intrare în allowlist, iar endpoint policies îți permit să restrângi, de exemplu, la ce bucket-uri are voie să ajungă traficul S3 al agentului.
Identitatea: un rol per agent, restrâns per task
A doua greșeală frecventă e că agentul rulează cu rolul aplicației. Aplicația web trebuie să citească și să scrie datele fiecărui client, deci poate și agentul. Dacă agentul depășește sarcina primită, o face cu permisiunile întregului produs.
Ce facem noi în schimb:
- Un rol IAM per tip de agent. Agentul de cercetare, cel de suport și cel de raportare au fiecare rolul lui, cu doar acțiunile de care au nevoie tool-urile lor. Un permissions boundary pe fiecare rol plafonează ce poate adăuga cineva mai târziu.
- O session policy per task. Când agentul pornește un task, orchestratorul își asumă rolul agentului cu o session policy inline care îl restrânge și mai mult, de exemplu la prefixul unui singur tenant din S3. Permisiunile efective sunt intersecția dintre rol și session policy.
- Sesiuni scurte și session tags. 15 minute, minimul pentru AssumeRole, și tag-uri pentru tenant și task, astfel încât fiecare apel din CloudTrail să poată fi legat de taskul care l-a făcut.
import { STSClient, AssumeRoleCommand } from "@aws-sdk/client-sts";

const sts = new STSClient({});

export async function credentialsForTask(taskId: string, tenantId: string) {
  const { Credentials } = await sts.send(new AssumeRoleCommand({
    RoleArn: process.env.RESEARCH_AGENT_ROLE_ARN,
    RoleSessionName: `agent-${taskId}`,
    DurationSeconds: 900,
    Tags: [{ Key: "tenant", Value: tenantId }, { Key: "task", Value: taskId }],
    Policy: JSON.stringify({
      Version: "2012-10-17",
      Statement: [{
        Effect: "Allow",
        Action: ["s3:GetObject"],
        Resource: [`arn:aws:s3:::${process.env.DOCS_BUCKET}/tenants/${tenantId}/*`],
      }],
    }),
  }));
  return Credentials;
}
Trust policy-ul rolului are nevoie de sts:TagSession ca tag-urile să funcționeze. Iar tool-urile agentului primesc aceste credențiale, nu pe cele implicite ale taskului, așa că până și un tool care se comportă greșit poate atinge doar fișierele unui singur tenant, timp de cincisprezece minute.
Tool-urile: suprafața reală de permisiuni
Rețeaua și IAM limitează unde poate merge un agent. Tool-urile decid ce poate face odată ajuns acolo, și aici se duce cea mai mare parte din munca de design.
- Fără tool-uri generice în producție. Un tool
bashsau unfetch(url)care acceptă orice face ca toate limitele de mai sus să rămână singurele limite. Un tool numitget_invoice(invoice_id)care verifică singur tenantul e mai puțin flexibil și mult mai sigur. - Verifică allowlist-ul și în tool. Dacă există un tool de fetch, el validează host-ul față de aceeași listă pe care o folosește firewall-ul. Defence in depth costă zece linii.
- Rulează codul într-un sandbox fără rețea. Dacă agentul trebuie să execute cod, fă-o într-un container sau o funcție separată, fără niciun egress, sau în sandbox-ul găzduit de furnizorul modelului, nu în procesul care deține credențialele.
- Aprobare pentru efecte secundare. Citirea e automată; tot ce scrie, trimite, plătește sau șterge așteaptă un om. Tool runner-ul din SDK-ul Anthropic are hook-uri per turn exact pentru asta, iar Managed Agents are permission policies (
always_allow,always_ask,auto).
O capcană din documentația Anthropic pe care am sublinia-o: în Managed Agents, tool-urile găzduite web_search și web_fetch rulează pe serverele Anthropic și ignoră setările de rețea ale mediului tău. Restricționarea rețelei sandbox-ului nu le limitează. Fie le oprești, fie le restricționezi per tool cu allowed_domains. E aceeași lecție ca la ocolirea DNS-ului, într-o altă formă: verifică ce cale urmează de fapt traficul.
Bugete și un kill switch
Ultimul strat privește comportamentul scăpat de sub control, nu acțiunile individuale. Setează o limită fermă de turn-uri și de tokeni per task (Claude API are task budgets exact pentru asta), limitează rata apelurilor de tool-uri per agent și urmărește două numere: alertele de drop din Network Firewall și blocările din DNS Firewall pentru subrețelele agentului. Un agent care începe brusc să lovească firewall-ul fie e stricat, fie face ceva ce nu ar trebui. Oricum ar fi, o alarmă CloudWatch pe aceste metrici poate declanșa un Lambda care atașează rolului agentului o policy deny-all. Toate sesiunile mor în câteva minute, iar restul produsului nu e afectat.
Checklist-ul nostru
Înainte ca un agent cu tool-uri să ajungă în producție, vrem să putem răspunde cu da la fiecare dintre punctele de mai jos:
- Agentul rulează în subrețele fără rută spre internet decât printr-un firewall sau proxy cu allowlist.
- Egress-ul către IP-uri goale e blocat, iar DNS-ul e filtrat și el.
- Serviciile AWS sunt accesate prin VPC endpoints.
- Agentul are rolul lui, un permissions boundary și session policies per task.
- Tool-urile sunt specifice, își verifică singure inputurile, iar efectele secundare cer aprobare.
- Execuția de cod are loc într-un sandbox fără rețea și fără credențiale.
- Turn-urile, tokenii și apelurile de tool-uri au limite și există un kill switch testat.
Nimic din toate acestea nu e exotic. E aceeași disciplină pe care o aplicăm oricărui serviciu care primește input nesigur, aplicată unui serviciu ale cărui decizii le ia un model. Dacă duci agenți în producție și vrei pe cineva care să-ți revizuiască setup-ul, e o muncă pe care o facem pentru clienți. Iar dacă vrei contextul despre motivul pentru care agenții tot găsesc breșele, am scris despre asta în de ce tot „evadează” AI-ul.