Pe 22 septembrie 2026 Anthropic a lansat Claude Opus 5.5 cu o frază care o să apară în multe ședințe de buget: Opus 5.5 „are performanța lui Claude Fable 5.1 pe majoritatea sarcinilor și costă cu 40% mai puțin de rulat decât Opus 5”. Pe token înseamnă 4 dolari la intrare și 20 la ieșire. Fable 5.1, cel mai capabil model pe care Anthropic îl vinde pe scară largă, costă 10 și 50. Adică 60% mai puțin pe token pentru rezultate comparabile, pe majoritatea sarcinilor.
Acum o lună am scris despre Fable 5.1 vs Fable 5 și am încheiat spunând că Opus 5 la effort mare acoperea o bună parte din ce face Fable. Cu Opus 5.5 argumentul devine mai puternic, dar „majoritatea sarcinilor” nu înseamnă „toate”, cei 40% au o notă de subsol, iar migrarea de pe Opus 5 vine cu patru schimbări care strică cod. Articolul trece prin toate trei. Prețurile și comportamentul API vin din documentația oficială Anthropic. Scenariile de cost sunt ale noastre, cu presupunerile scrise explicit.
Cele trei modele, într-un tabel
| Opus 5.5 | Fable 5.1 | Opus 5 | |
|---|---|---|---|
| Context / output maxim | 1M / 128K | 1M / 128K | 1M / 128K |
| Intrare / ieșire ($ per MTok) | 4 / 20 | 10 / 50 | 5 / 25 |
| Citire din cache ($ per MTok) | 0,20 | 0,25 | 0,50 |
| Scriere în cache, 5 min ($ per MTok) | 5,00 | 12,50 | 6,25 |
| Batch ($ per MTok) | 2 / 10 | 5 / 25 | 2,50 / 12,50 |
| Thinking | mereu pornit | mereu pornit | pornit implicit, se poate opri până la high |
| Effort implicit | medium | high | high |
tool_choice forțat (any / tool) |
400 | 400 | permis |
| Fast mode | da, 8 / 40 | nu | da, 10 / 50 |
| Retenția datelor | nicio cerință suplimentară listată | 30 de zile obligatoriu, fără ZDR fără aprobare | ZDR disponibil |
| Tokenizer | același la toate trei |
Două rânduri sunt ușor de ratat. Primul: tokenizerul e același pe toate trei modelele, deci același prompt costă același număr de tokeni peste tot, iar comparația e cu adevărat despre preț și comportament. Al doilea: Opus 5.5 în fast mode, la 8 / 40 dolari, e tot mai ieftin pe token decât Fable 5.1 standard. Dacă pe un flux te doare latența, nu calitatea, acum ai o opțiune reală.
De unde vine „cu 40% mai ieftin”
Pe token, Opus 5.5 e cu 20% mai ieftin decât Opus 5: 4 dolari față de 5 și 20 față de 25. Citirea din cache a scăzut mai mult, de la 0,50 la 0,20. Atunci de unde vin 40%?
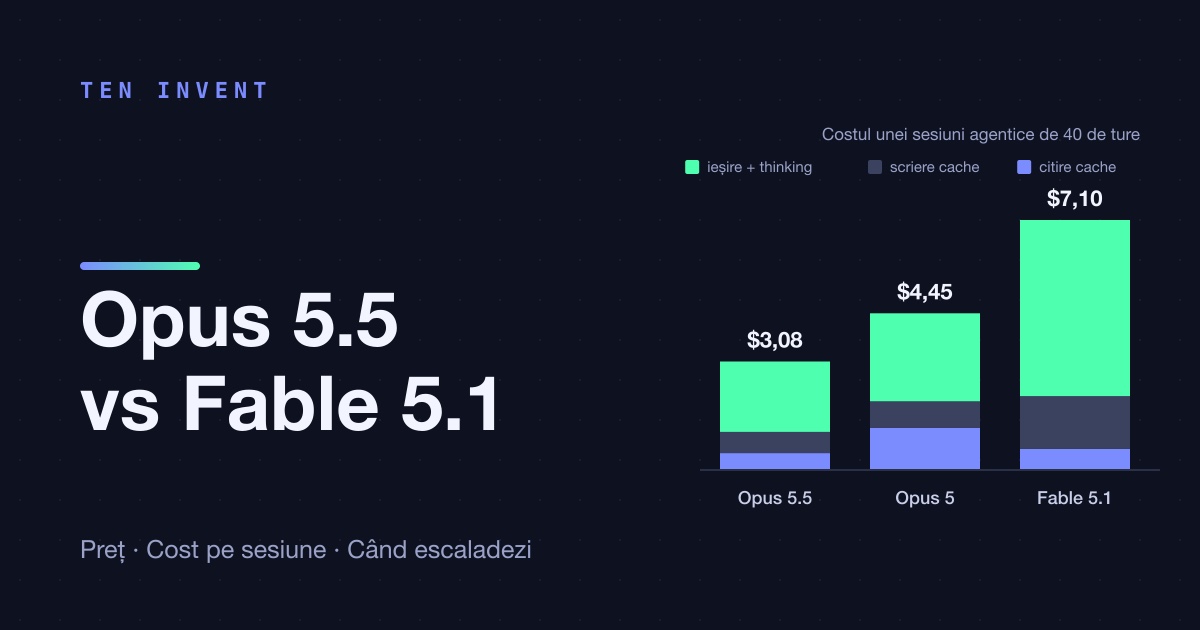
Am pus preț pe o sesiune tipică de coding agentic: 40 de ture, fiecare citind din cache cam 60K tokeni de istoric, scriind 3K tokeni noi în cache și producând 2,5K tokeni de ieșire, inclusiv thinking. Cu același număr de tokeni pe fiecare model, sesiunea costă 3,08 dolari pe Opus 5.5, 4,45 pe Opus 5 și 7,10 pe Fable 5.1.
Cu număr identic de tokeni, Opus 5.5 iese cu 31% mai ieftin decât Opus 5, nu cu 40%. Restul trebuie să vină din faptul că Opus 5.5 folosește mai puțini tokeni pentru aceeași sarcină, iar o bună parte din asta e o setare: effort-ul implicit pe Opus 5.5 e medium, cu un nivel sub high-ul de pe Opus 5. Dacă schimbi ID-ul modelului și nimic altceva, rulezi la effort mai mic, deci cu mai puțin thinking și mai puțini tokeni de ieșire. Uneori e exact ce trebuie. Alteori e o scădere tăcută de calitate pe fluxurile grele, pe care o observi abia după câteva săptămâni. Documentația e explicită: setează tu effort-ul și refă calibrarea pe evaluările tale.
Al doilea lucru pe care îl arată graficul e că ieșirea e cel mai mare cost pe fiecare model, iar diferența față de Fable 5.1 e cea mai mare exact acolo: 20 de dolari față de 50 pe milion. Pe profilul ăsta, Fable 5.1 iese mai ieftin doar dacă Opus 5.5 are nevoie de aproximativ 2,3 ori mai mulți tokeni ca să termine aceeași sarcină. Asta se întâmplă pe sarcinile cele mai grele, unde modelul mai slab se învârte în cerc, reîncearcă și tot nu reușește. Pe munca obișnuită nu se întâmplă.
Ce se strică dacă ești pe Opus 5
Opus 5.5 păstrează contextul, limita de output, tokenizerul și setul de funcții de la Opus 5. Se schimbă patru lucruri, iar trei dintre ele întorc erori:
- Thinking-ul nu se mai poate opri.
thinking: {type: "disabled"}șibudget_tokensîntorc amândouă 400 la orice nivel de effort. Effort-ul e singurul control. Dacă aveai un flux pe Opus 5 cu thinking oprit pentru latență, coboară effort-ul lalow. - Folosirea forțată a tool-urilor întoarce 400.
tool_choicecuanysau cu un tool numit e respins, inclusiv pecount_tokensși pe Batches. Foloseșteauto, spune în prompt ce tool să apeleze și adaugăstrict: truepe tool dacă ai nevoie de argumente valide conform schemei. Dacă apelul forțat exista doar ca să primești JSON, folosește structured outputs. - Blocurile de thinking sunt legate de model și de conversație. Editarea turelor anterioare invalidează blocurile de thinking de după ele, iar conturile create pe 31 august 2026 sau după primesc 400 pe istoric editat. Harness-ul trebuie să fie append-only. Dacă al tău taie, rescrie sau reordonează istoricul, aici e adevărata muncă de migrare.
- Computer use trece prin
computer_toolset_20260801în Claude API și pe Google Cloud. Vechiulcomputer_20251124întoarce 400 acolo.
Mai sunt schimbări care nu fac cererile să eșueze. Textul pe care modelul îl scrie între apelurile de tool-uri vine acum ca blocuri thinking de progres, goale dacă nu setezi display: "updates". Iar clasificatorii de siguranță sunt mai largi: bio se adaugă lângă cyber și reasoning_extraction. Recomandăm activarea fallback-urilor pe server, ca un refuz pe o cerere legitimă să fie reîncercat pe alt model, nu să se oprească.
const response = await client.beta.messages.create({
  model: "claude-opus-5-5",
  max_tokens: 64000,
  output_config: { effort: "high" }, // set it; the default is medium
  betas: ["server-side-fallback-2026-07-01"],
  fallbacks: "default", // routes by refusal category
  messages,
  tools,
});
Când mai merită Fable 5.1
„Majoritatea sarcinilor” lasă loc. În articolul despre Fable am listat zonele unde Anthropic spune că modelul de top câștigă cel mai mult: sesiuni lungi de coding agentic, de ore, documente și foi de calcul construite de la zero, cercetare în mai mulți pași, vision pe grafice dense și PDF-uri scanate, retrieval adânc în fereastra de 1M și computer use cu recuperare din pași eșuați. Acolo am păstra Fable 5.1 în setul de teste și acolo ne-am aștepta să fie depășit pragul de 2,3× de mai sus.
Există și motive să nu folosești Fable 5.1 care n-au legătură cu capabilitatea. Fable 5.1 cere retenția datelor 30 de zile și nu e disponibil cu zero data retention decât dacă Anthropic aprobă explicit. Pentru un client din banking sau sănătate cu obligație contractuală de ZDR, discuția se încheie înainte să se uite cineva la vreun benchmark. Nu are nici fast mode, iar niciunul dintre modele nu e pe Priority Tier.
Un detaliu face ca cele două modele să meargă bine împreună. Blocurile de thinking ale lui Opus 5.5 pot fi citite de Fable 5.1 în Claude API. Deci poți rula o conversație pe Opus 5.5 și escalada tura grea pe Fable 5.1 fără ca modelul mai puternic să piardă raționamentul de dinainte. În sens invers, de pe Opus 5.5 înapoi pe Opus 5, thinking-ul anterior se pierde. Dacă construiești o cale de escaladare, construiește-o în sus.
Cum am decide, flux cu flux
Ideea fluxului e că modelul se alege pe fiecare flux în parte. Cele mai multe companii cu care lucrăm au câteva fluxuri de AI: unul care scrie cod, unul care răspunde clienților, unul care extrage date, unul care rezumă. Nu toate au nevoie de același model. Fluxul de extragere probabil merge pe Haiku 5.5, cel pentru clienți pe Sonnet sau Opus la effort mic, iar poate un singur flux, cel care face muncă lungă și autonomă, își merită Fable 5.1.
Recomandarea noastră
Fă din Opus 5.5 modelul implicit pentru munca nouă și pentru tot ce rulează acum pe Opus 5. Migrarea durează o zi dacă harness-ul tău e deja append-only și nu forțează apeluri de tool-uri, și mai mult dacă nu e așa. Setează effort-ul explicit pe fiecare flux, pentru că altfel noul medium implicit o să decidă în locul tău. Păstrează Fable 5.1 pentru fluxurile unde propriile evaluări arată că Opus 5.5 la xhigh tot nu e suficient. Ca preț, ăsta e pragul pe care trebuie să-l treacă: de 2,5 ori costul pe token.
Dacă folosești un abonament Claude Max în loc de API, calculul e altul, și l-am făcut în Claude Max vs API. Dacă vrei ajutor să măsori ce flux are nevoie de ce model, e exact genul de muncă pe care o facem pentru clienți.