Am 22. September 2026 hat Anthropic Claude Opus 5.5 mit einem Satz veröffentlicht, der in vielen Budgetrunden landen wird: Opus 5.5 „erreicht bei den meisten Aufgaben das Niveau von Claude Fable 5.1 und kostet im Betrieb 40 % weniger als Opus 5“. Pro Token sind es 4 $ für Input und 20 $ für Output. Fable 5.1, das leistungsfähigste Modell, das Anthropic breit anbietet, kostet 10 $ und 50 $. Das sind 60 % weniger pro Token für, bei den meisten Aufgaben, vergleichbare Ergebnisse.
Vor einem Monat haben wir über Fable 5.1 vs Fable 5 geschrieben und am Ende gesagt, dass Opus 5 mit hohem Effort einen großen Teil dessen abdeckt, was Fable leistet. Mit Opus 5.5 wird dieses Argument stärker, aber „die meisten Aufgaben“ sind nicht „alle Aufgaben“, die 40 % haben eine Fußnote, und die Migration von Opus 5 bringt vier Breaking Changes mit sich. Dieser Artikel geht alle drei Punkte durch. Die Preise und das API-Verhalten stammen aus der offiziellen Dokumentation von Anthropic. Die Kostenszenarien sind unsere, mit ausgeschriebenen Annahmen.
Die drei Modelle in einer Tabelle
| Opus 5.5 | Fable 5.1 | Opus 5 | |
|---|---|---|---|
| Kontext / max. Output | 1M / 128K | 1M / 128K | 1M / 128K |
| Input / Output ($ pro MTok) | 4 / 20 | 10 / 50 | 5 / 25 |
| Cache-Read ($ pro MTok) | 0,20 | 0,25 | 0,50 |
| Cache-Write, 5 Min. ($ pro MTok) | 5,00 | 12,50 | 6,25 |
| Batch ($ pro MTok) | 2 / 10 | 5 / 25 | 2,50 / 12,50 |
| Thinking | immer an | immer an | standardmäßig an, bis high abschaltbar |
| Standard-Effort | medium | high | high |
Erzwungenes tool_choice (any / tool) |
400 | 400 | erlaubt |
| Fast Mode | ja, 8 / 40 | nein | ja, 10 / 50 |
| Datenaufbewahrung | keine zusätzliche Anforderung genannt | 30 Tage erforderlich, kein ZDR ohne Freigabe | ZDR verfügbar |
| Tokenizer | bei allen dreien gleich |
Zwei Zeilen übersieht man leicht. Erstens ist der Tokenizer bei allen drei Modellen derselbe, sodass derselbe Prompt überall dieselbe Token-Anzahl kostet und der Vergleich wirklich nur Preis und Verhalten betrifft. Zweitens ist Opus 5.5 im Fast Mode, mit 8 $ / 40 $, pro Token immer noch günstiger als Fable 5.1 im Standardbetrieb. Wenn bei einer Route die Latenz schmerzt und nicht die Qualität, ist das jetzt eine echte Option.
Woher die „40 % günstiger“ kommen
Pro Token ist Opus 5.5 20 % günstiger als Opus 5: 4 $ gegenüber 5 $ und 20 $ gegenüber 25 $. Der Preis für Cache-Reads ist stärker gesunken, von 0,50 $ auf 0,20 $. Woher kommen also die 40 %?
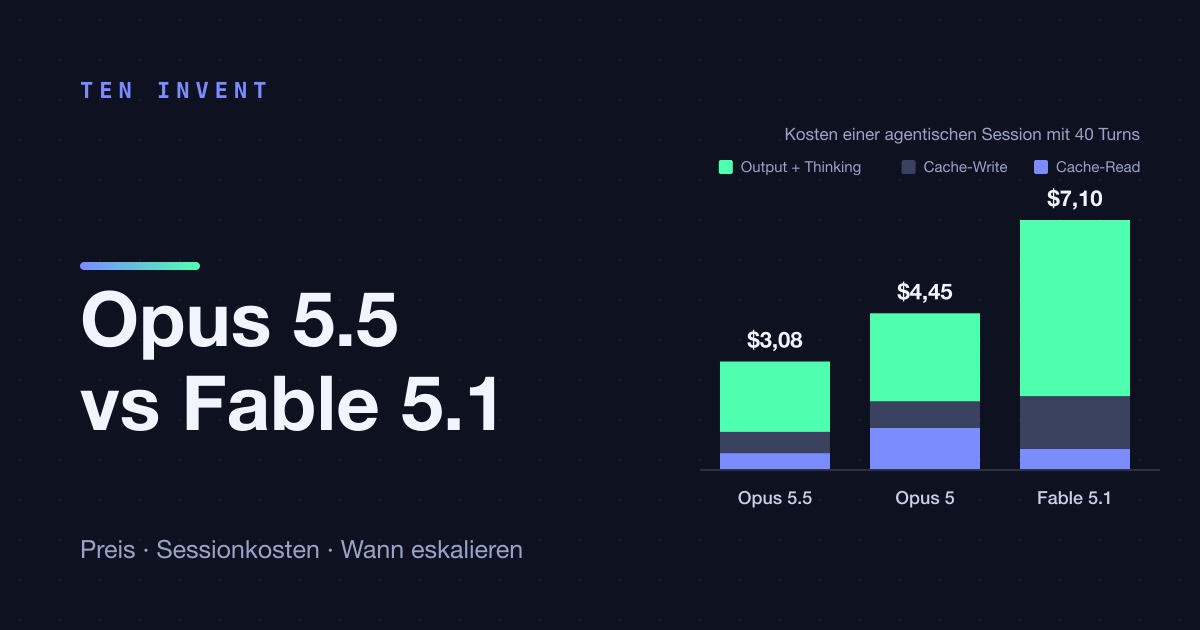
Wir haben eine typische agentische Coding-Session durchgerechnet: 40 Turns, in jedem werden etwa 60K Tokens Verlauf aus dem Cache gelesen, 3K neue Tokens in den Cache geschrieben und 2,5K Output-Tokens inklusive Thinking erzeugt. Bei gleicher Token-Anzahl auf jedem Modell kostet die Session 3,08 $ mit Opus 5.5, 4,45 $ mit Opus 5 und 7,10 $ mit Fable 5.1.
Bei identischen Token-Zahlen ist Opus 5.5 um 31 % günstiger als Opus 5, nicht um 40 %. Der Rest muss daher kommen, dass Opus 5.5 für dieselbe Aufgabe weniger Tokens verbraucht, und ein großer Teil davon ist eine Einstellung: Der Standard-Effort bei Opus 5.5 ist medium, eine Stufe unter dem high von Opus 5. Wenn Sie die Modell-ID ändern und sonst nichts, laufen Sie mit niedrigerem Effort, also mit weniger Thinking und weniger Output-Tokens. Manchmal ist das genau richtig. Manchmal ist es ein stiller Qualitätsverlust bei schwierigen Routen, den Sie erst Wochen später bemerken. Die Dokumentation ist eindeutig: Setzen Sie den Effort selbst und wiederholen Sie den Effort-Sweep mit Ihren eigenen Evals.
Das Zweite, was das Diagramm zeigt: Der Output ist bei jedem Modell der größte Kostenfaktor, und der Abstand zu Fable 5.1 ist genau dort am größten: 20 $ gegenüber 50 $ pro Million. In diesem Profil kommt Fable 5.1 nur dann günstiger weg, wenn Opus 5.5 etwa 2,3-mal so viele Tokens braucht, um dieselbe Aufgabe zu beenden. Das passiert bei den schwersten Aufgaben, wo das schwächere Modell sich im Kreis dreht, es erneut versucht und trotzdem scheitert. Bei gewöhnlicher Arbeit passiert es nicht.
Breaking Changes, wenn Sie auf Opus 5 sind
Opus 5.5 behält Kontext, Output-Limit, Tokenizer und Funktionsumfang von Opus 5. Vier Dinge ändern sich, und drei davon liefern Fehler:
- Thinking lässt sich nicht abschalten.
thinking: {type: "disabled"}undbudget_tokensliefern bei jedem Effort-Level einen 400. Der Effort ist die einzige Stellschraube. Wenn Sie bei Opus 5 eine Route mit abgeschaltetem Thinking wegen der Latenz hatten, senken Sie stattdessen den Effort auflow. - Erzwungene Tool-Nutzung liefert einen 400.
tool_choicemitanyoder einem benannten Tool wird abgelehnt, auch beicount_tokensund Batches. Verwenden Sieauto, sagen Sie im Prompt, welches Tool aufzurufen ist, und ergänzen Siestrict: trueam Tool, wenn Sie schemakonforme Argumente brauchen. Wenn der erzwungene Aufruf nur dazu diente, JSON zurückzubekommen, nutzen Sie Structured Outputs. - Thinking-Blöcke sind an das Modell und die Konversation gebunden. Das Bearbeiten früherer Turns macht die danach folgenden Thinking-Blöcke ungültig, und Konten, die am oder nach dem 31. August 2026 erstellt wurden, erhalten bei bearbeitetem Verlauf einen 400. Das Harness muss append-only arbeiten. Wenn Ihres Verlauf kürzt, umschreibt oder umsortiert, ist das die eigentliche Migrationsarbeit.
- Computer Use läuft über
computer_toolset_20260801in der Claude API und auf Google Cloud. Das älterecomputer_20251124liefert dort einen 400.
Daneben gibt es Änderungen, die keine Anfragen scheitern lassen. Text, den das Modell zwischen Tool-Aufrufen schreibt, kommt jetzt als thinking-Blöcke mit Fortschrittsmeldungen zurück, leer, solange Sie nicht display: "updates" setzen. Und die Safety-Klassifizierer sind breiter: bio kommt zu cyber und reasoning_extraction hinzu. Wir empfehlen, serverseitige Fallbacks einzuschalten, damit eine Ablehnung bei einer legitimen Anfrage auf einem anderen Modell wiederholt wird, statt abzubrechen.
const response = await client.beta.messages.create({
  model: "claude-opus-5-5",
  max_tokens: 64000,
  output_config: { effort: "high" }, // set it; the default is medium
  betas: ["server-side-fallback-2026-07-01"],
  fallbacks: "default", // routes by refusal category
  messages,
  tools,
});
Wann Fable 5.1 sich weiterhin lohnt
„Die meisten Aufgaben“ lässt Spielraum. Im Fable-Artikel haben wir die Bereiche aufgelistet, in denen laut Anthropic das Spitzenmodell am meisten gewinnt: lange agentische Coding-Sessions über Stunden, von Grund auf erstellte Dokumente und Tabellen, mehrstufige Recherche, Vision bei dichten Diagrammen und gescannten PDFs, Retrieval tief im 1M-Fenster sowie Computer Use mit Wiederaufnahme nach fehlgeschlagenen Schritten. Dort würden wir Fable 5.1 im Testset behalten, und dort würden wir erwarten, dass der oben genannte Break-even von 2,3× überschritten wird.
Es gibt auch Gründe, Fable 5.1 nicht zu verwenden, die nichts mit Leistungsfähigkeit zu tun haben. Fable 5.1 verlangt 30 Tage Datenaufbewahrung und ist unter Zero Data Retention nicht verfügbar, sofern Anthropic es nicht ausdrücklich freigibt. Für einen Kunden aus dem Bank- oder Gesundheitswesen mit vertraglicher ZDR-Pflicht beendet das die Diskussion, bevor jemand einen Benchmark ansieht. Einen Fast Mode gibt es ebenfalls nicht, und keines der beiden Modelle ist im Priority Tier.
Ein Detail lässt die beiden Modelle gut zusammenarbeiten. Die Thinking-Blöcke von Opus 5.5 kann Fable 5.1 in der Claude API lesen. Sie können also eine Konversation auf Opus 5.5 führen und den schwierigen Turn an Fable 5.1 eskalieren, ohne dass das stärkere Modell das vorherige Reasoning verliert. In der Gegenrichtung, von Opus 5.5 hinunter zu Opus 5, geht das frühere Thinking verloren. Wenn Sie einen Eskalationspfad bauen, bauen Sie ihn nach oben.
Wie wir entscheiden würden, Route für Route
Der Kern des Ablaufs: Das Modell ist eine Entscheidung pro Route. Die meisten Unternehmen, mit denen wir arbeiten, haben eine Handvoll KI-Routen: eine, die Code schreibt, eine, die Kunden antwortet, eine, die Daten extrahiert, eine, die zusammenfasst. Sie brauchen nicht alle dasselbe Modell. Die Extraktions-Route gehört vermutlich zu Haiku 5.5, die Kunden-Route zu Sonnet oder Opus mit niedrigem Effort, und vielleicht verdient sich eine Route, die mit den langen autonomen Aufgaben, Fable 5.1.
Unsere Empfehlung
Machen Sie Opus 5.5 zum Standard für neue Arbeiten und für alles, was derzeit auf Opus 5 läuft. Die Migration ist ein Tag Arbeit, wenn Ihr Harness bereits append-only ist und keine Tool-Aufrufe erzwingt, und mehr, wenn nicht. Setzen Sie den Effort bei jeder Route explizit, denn der neue Standard medium trifft die Entscheidung sonst für Sie. Behalten Sie Fable 5.1 für die Routen, bei denen Ihre eigenen Evals zeigen, dass Opus 5.5 mit xhigh immer noch nicht ausreicht. Preislich ist das die Hürde, die es nehmen muss: das 2,5-Fache der Kosten pro Token.
Wenn Sie ein Claude-Max-Abonnement statt der API nutzen, sieht die Rechnung anders aus, und das haben wir in Claude Max vs API behandelt. Wenn Sie Hilfe dabei möchten, zu messen, welche Ihrer Routen welches Modell braucht, ist das genau die Art von Arbeit, die wir für Kunden erledigen.