KI, die in Produktion geht, nicht nur in eine Präsentation.
Wir bringen Sprachmodell-Funktionen in die Software, die Sie bereits betreiben: Dokumentenverarbeitung, Assistenten, Agenten, die Aktionen ausführen, Suche, die Fragen versteht. Gemessen, überwacht und bepreist wie jedes andere Feature.
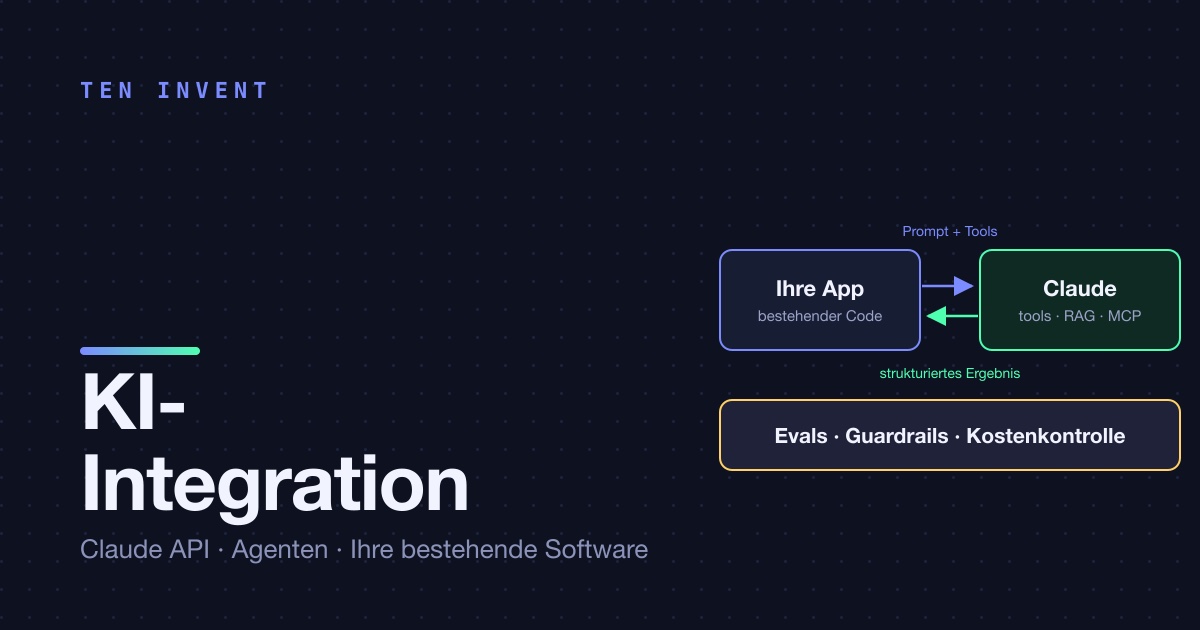
Jedes Unternehmen hat die Demo schon gesehen. Weniger haben erlebt, wie das Feature echte Nutzer, echte Dokumente und eine echte Rechnung übersteht. Der Unterschied liegt im Engineering: Retrieval, das den richtigen Ausschnitt liefert, Prompts unter Versionskontrolle, Evals, die bei jeder Änderung laufen, und Kosten sowie Latenz, die tatsächlich jemand im Blick behält.
Wir bauen auf Claude über AWS Bedrock oder die Anthropic API, mit Agent-Frameworks, MCP-Tool-Servern und RAG-Pipelines, dort wo sie sich lohnen. Wir haben dieselben Workloads auch schon auf offenen Modellen betrieben, wenn Datenresidenz oder Kosten es verlangten. Unsere eigenen Produkte, Bob AI und die Agent-Factory-Plattform, laufen nach denselben Prinzipien.
Vom Use Case zum überwachten Feature.
Use-Case-Discovery und Machbarkeit
Ein kurzer Spike auf Ihren echten Daten beantwortet die einzige Frage, die zählt: Leistet das Modell das zuverlässig genug, um es zu bauen? Mit Zahlen, nicht mit Meinungen.
LLM-Funktionen in bestehenden Produkten
Zusammenfassungen, Extraktion, Klassifikation, Textentwürfe und Q&A, eingebunden in Ihr bestehendes Backend, mit typisierten Ausgaben, auf die sich Ihr Code verlassen kann.
Agenten, die Aktionen ausführen
Werkzeugnutzende Agenten auf Bedrock oder der Claude API, mit MCP-Servern für Ihre Systeme, Guardrails, menschlichen Freigabeschritten und einem Audit-Trail.
RAG und Suche über Ihre Dokumente
Ingestion, Chunking, Embeddings, hybride Suche und Re-Ranking auf PostgreSQL/pgvector oder OpenSearch, abgestimmt auf Ihren Datenbestand, nicht auf einen Benchmark.
Evals, Observability und Kostenkontrolle
Golden Datasets, automatisierte Evals in der CI, Tracing jedes einzelnen Aufrufs, Token-Budgets und Alerts. Sie erfahren, wenn die Qualität sinkt, bevor Ihre Nutzer es tun.
Private und offene Modelle
Wenn Daten Ihre VPC nicht verlassen dürfen, betreiben wir offene Modelle auf Ihrer eigenen Infrastruktur und gestalten die Kompromisse ehrlich.
Was Sie erhalten
- Ein Machbarkeitsbericht mit gemessener Genauigkeit, Latenz und Kosten auf Ihren eigenen Daten
- Produktionscode in Ihrem Repository: Prompts, Tools, Pipelines und typisierte Schnittstellen
- Eval-Suite und Golden Dataset, die bei jeder Änderung automatisch laufen
- Tracing, Dashboards und Alerts für Qualität, Latenz und Ausgaben
- Eine schriftliche Modell- und Datenrichtlinie, die Ihre Rechtsabteilung absegnen kann
Das ist für Sie, wenn
- Sie haben einen sich wiederholenden, sprachlastigen Prozess (Dokumente, Tickets, E-Mails, Berichte), den niemand mehr von Hand machen möchte
- Sie haben einen Prototyp gebaut, der das Board beeindruckt hat, und brauchen ihn jetzt kundentauglich
- Sie wollen einen Assistenten oder Agenten in Ihrem Produkt, der sicher, gemessen und bezahlbar ist
Wie ein Projekt abläuft
Sie bekommen einen Senior-Ingenieur, der wie ein kleines Team liefert — mit einem transparenten Stundensatz, woechentlichem Reporting und ohne Agentur-Overhead. Skalieren Sie die Stunden je nach Projektbedarf.
- 01Spike — ein bis zwei Wochen auf echten Daten, um zu messen, ob das Modell die Aufgabe leistet und was es kostet.
- 02Design — Architektur, Datenfluss, Guardrails, Eval-Plan und Kostenmodell, vor dem Bau abgestimmt.
- 03Build — das Feature, seine Tools und Pipelines, mit Evals in der CI ab der ersten Woche und einem stufenweisen Rollout.
- 04Betrieb — Monitoring, Prompt- und Modell-Updates, Kostenreviews und die Option, dass wir an Bord bleiben.
Fragen, die wir vor jedem Projekt hören
Welche Modelle setzen Sie ein?
Meist Claude, über AWS Bedrock, wenn Sie auf AWS sind, oder über die Anthropic API sonst. Wir wählen das kleinste Modell, das Ihre Evals besteht, und haben offene Modelle auf privater Infrastruktur betrieben, wenn Datenresidenz das erforderte. Wir sind an keinen Anbieter gebunden.
Werden unsere Daten zum Training verwendet?
Nein. Bei Bedrock und der Anthropic API werden Prompts und Ausgaben nicht für Training verwendet. Wir dokumentieren genau, welche Daten wohin gehen, und für sensible Workloads bleibt alles innerhalb Ihrer VPC.
Woher wissen Sie, dass es funktioniert?
Wir erstellen früh ein Golden Dataset aus Ihren echten Fällen, definieren gemeinsam mit Ihnen, was „richtig" bedeutet, und lassen Evals bei jeder Änderung automatisch laufen. Die Zahlen entscheiden, ob eine Prompt- oder Modelländerung ausgeliefert wird.
Was ist mit Halluzinationen?
Wir gestalten dafür vor: Retrieval mit Quellenangaben, strukturierte Ausgaben, die vom Code validiert werden, Konfidenzschwellen mit menschlicher Prüfung und Agenten, die vor dem Handeln nachfragen. Das Ziel ist ein System, das sicher und sichtbar scheitert, statt so zu tun, als sei es perfekt.
Was wird der Betrieb kosten?
Wir messen den Token-Verbrauch pro Anfrage während des Spikes und nennen Ihnen einen Preis pro Dokument, Ticket oder Konversation, bevor Sie sich festlegen. Budgets und Alerts sind Teil des Baus, kein nachträglicher Gedanke.
Wie wir darüber denken
Wie wir KI-Integration bauen: ein zweiwöchiger Spike, ein Golden Dataset, und eine Rechnung, die man vorhersehen kann
Drei von uns gebaute KI-Systeme sind heute in Produktion. Ein Recherche-Assistent für einen US-Kunden, der auf AWS Bedro...
September 2026
KI-Agenten im Enterprise-Maßstab: Was uns BNY Mellons Deployment von 20.000 Agenten lehrt
Anfang 2026 geschah etwas Bemerkenswertes im Finanzsektor. BNY Mellon, die größte Depotbank der Welt mit über 50 Billion...
März 2026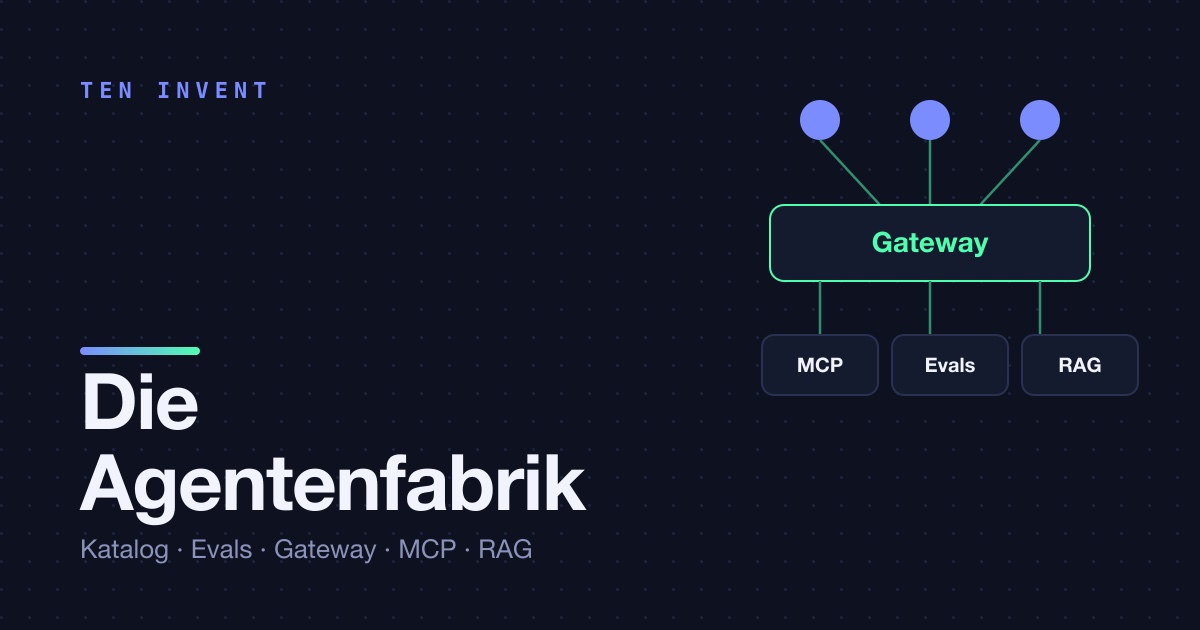
Bau keinen Agenten. Bau die Agentenfabrik.
Einen KI-Agenten kann jeder an einem Wochenende bauen. Ein gutes Modell, ein paar Tools, ein anständiger System-Prompt —...
August 2026Haben Sie einen Prozess, den KI übernehmen sollte?
Flexible Engagements auf Stundenbasis / Time-and-Materials, vollstaendig remote, B2B. Direkte Kommunikation mit dem Ingenieur, der die Arbeit macht — keine Uebergaben, kein Sales-Pitch.